

Vue d’ensemble
Les SDK de Kameleoon vous permettent de mener des expériences pour ameliorer l’experience utilisateur dans les applications web et mobiles. D’apres le schema ci-dessous, l’implementation d’une expérience avec un SDK Kameleoon comporte trois etapes : initialisation, identification de l’utilisateur et affectation des attributs, et attribution et suivi des variations. Cet article fournira une explication detaillee de chacune de ces etapes.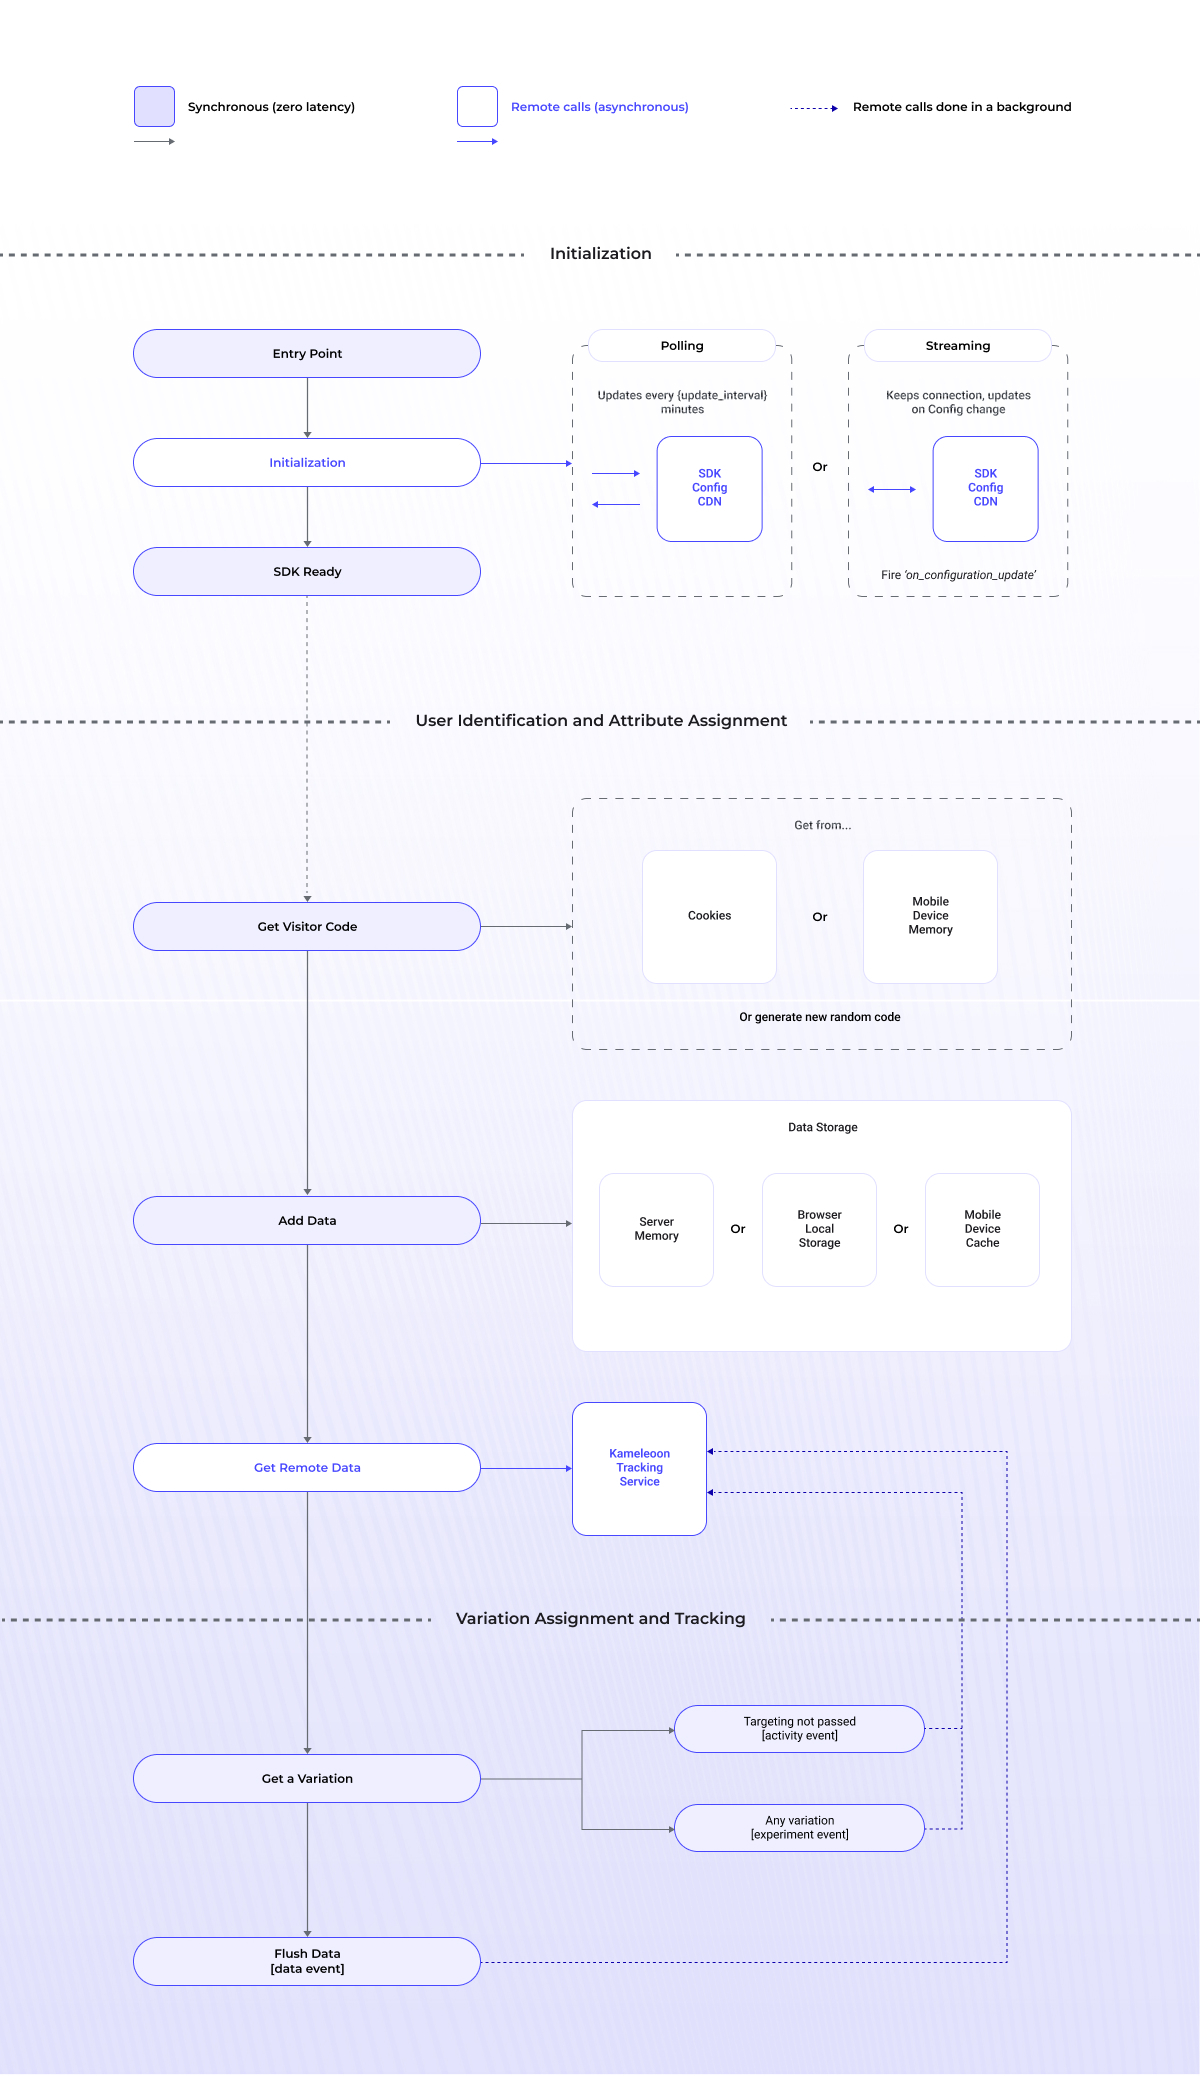
Les methodes (et leurs noms) decrites dans chaque etape ci-dessous auront des syntaxes differentes, en fonction de la convention du langage particulier du SDK.
1. Initialisation
Lors de l’initialisation, le SDK recupere toute configuration mise a jour des feature flags en utilisant le Content Delivery Network de Cloudflare via deux methodes : le Polling, une option par defaut ou le SDK envoie regulierement une requete au CDN (l’intervalle par defaut est de 60 minutes) pour obtenir la configuration la plus recente, et le Streaming, une option premium ou le SDK Kameleoon est notifie en temps reel des changements de configuration via des server-sent events (SSE). Une fois les configurations recuperees, le SDK commence l’attribution du visitor code ainsi que les variations et le processus de ciblage. Pour plus d’informations, consultez les considerations techniques.Comme le montre le schema, pendant le Streaming, la methode
on_configuration_update (rappelez-vous, le nom varie selon les SDK) vous permet de gerer l’evenement lorsque la configuration a ete mise a jour. Elle prend un parametre d’entree handler. Le handler sera appele lorsque la configuration est mise a jour a l’aide d’un evenement de configuration en temps reel. Pour plus d’informations, veuillez consulter les SDK individuels Web et Mobile.2. Identification de l’utilisateur et affectation des attributs
A ce stade, pour calculer la variation, le visitor code est attribue et les attributs utilisateur sont integres :-
1. Attribution du visitor code : L’initialisation offre la possibilite d’attribuer un ID unique a un visiteur. Pour les SDK web, la methode
getVisitorCode()recupere un visitor code depuis le cookie des en-tetes de requete. Si le visitor code n’existe pas, la methode genere un visitor code aleatoire et le stocke dans un cookie d’en-tete de reponse. Pour les SDK mobiles, le visitor code est obtenu depuis la memoire de l’appareil mobile. -
2. Ajout d’attributs utilisateur a des fins de ciblage : Les conditions de ciblage de Kameleoon permettent d’activer des feature flags en fonction des attributs utilisateur. Pour utiliser ces conditions efficacement, definissez les valeurs a l’aide de la methode
addData()et/ougetRemoteVisitorData()pour recuperer et utiliser des criteres specifiques. Les attributs utilisateur sont ensuite stockes dans la memoire du serveur pour les SDK cote serveur, dans le local storage du navigateur pour les SDK cote client, ou dans la memoire de l’appareil pour les SDK mobiles. Pour plus de details, consultez l’article sur le stockage de donnees. -
3. Ajout de donnees externes a des fins de ciblage : Les donnees externes, telles que les preferences utilisateur ou les donnees CRM, peuvent etre stockees a l’aide de la Data API (une API REST) via l’endpoint POST. Ces donnees sont ensuite recuperees dans le SDK en utilisant la methode
getRemoteData().
3. Attribution et suivi des variations
Dans les SDK Kameleoon, la methodegetVariation() (isFeatureFlagActive() / getVariations()) recupere la configuration d’une expérience de feature qui contient plusieurs variations. Elle peut etre utilisee pour obtenir la ou les cles de variation attribuees a un utilisateur specifique.
Lorsqu’un visiteur remplit toutes les conditions de ciblage et les regles d’exposition pour le feature flag, Kameleoon utilise une fonction de hachage pour affecter le visiteur a une variation puis envoie un evenement d’expérience au service de suivi. Si le visiteur ne remplit pas les conditions, un evenement d’activite est envoye pour indiquer que l’utilisateur est actif sur l’application web ou mobile. De plus, la methode flush() peut etre utilisee pour envoyer toutes les autres donnees stockees au service de suivi.
4. Documents utiles
Pour les integrations specifiques a chaque langage, veuillez vous referer aux articles SDK Web et SDK Mobile : SDK Web SDK Mobile Ressources supplementairesFAQ
Quand est-il pertinent d'envoyer les données avec flush ?
Quand est-il pertinent d'envoyer les données avec flush ?
En général, vous n’avez pas besoin d’appeler manuellement la méthode
flush : les autres appels aux méthodes SDK envoient aussi les données. Toutefois, si vous devez envoyer des données à la Data API sans déclencher le feature flag du visiteur, utilisez la méthode flush.Quand le SDK envoie-t-il une requête de suivi pour l'analytique ?
Quand le SDK envoie-t-il une requête de suivi pour l'analytique ?
Par défaut, le SDK regroupe plusieurs événements et envoie une requête de suivi aux serveurs Kameleoon à des fins d’analyse, à intervalle configurable. Cette approche améliore l’efficacité et réduit la charge du serveur.Le SDK envoie une requête de suivi :
- Périodiquement : par défaut, le SDK envoie une requête toutes les 1 000 ms (1 seconde). Vous pouvez modifier cet intervalle en définissant la valeur tracking interval.
- À la demande : immédiatement, si votre code appelle une méthode comme
flush(instant=true).
getVariation(lorsquetrackest défini surtrue).getVariations(lorsquetrackest défini surtrue).isFeatureFlagActive(lorsquetrackest défini surtrue).trackConversionflush(avec ou sansinstant=true)
activityTrackingIntervalMillisecond (ou activity_tracking_interval_millisecond) dans la configuration de votre SDK.Pour les SDK côté serveur, le regroupement des événements est particulièrement utile, car chaque requête de suivi peut consolider les données de plusieurs visiteurs dans une seule requête. Cette approche agrège les informations de tous les visiteurs concernés et les envoie une fois par intervalle, ce qui améliore l’efficacité et réduit la charge du serveur.Quelles méthodes déclenchent des requêtes HTTP ? Sont-elles synchrones ou asynchrones ?
Quelles méthodes déclenchent des requêtes HTTP ? Sont-elles synchrones ou asynchrones ?
Selon les SDK, ces méthodes peuvent porter des noms différents en raison des spécificités de chaque langage.
- isFeatureFlagActive / getVariation / trackConversion / flush
- Ces méthodes envoient des requêtes asynchrones à la Data API pour stocker toutes les informations sur le visiteur (y compris les variations reçues par l’utilisateur). Kameleoon utilise ces informations pour afficher les statistiques dans app.kameleoon.com
- getRemoteData / getRemoteVisitorData / getVisitorWarehouseAudience
- Ces méthodes envoient des requêtes à la Data API pour obtenir des informations sur le visiteur. Dans le SDK JavaScript, elles sont asynchrones : vous devez donc attendre le résultat (await) avant de l’utiliser.
- Par ailleurs, le SDK envoie des requêtes asynchrones pour obtenir la configuration nécessaire à son fonctionnement interne.
Quand dois-je utiliser isFeatureFlagActive ou getVariation ?
Quand dois-je utiliser isFeatureFlagActive ou getVariation ?
Appelez
isFeatureFlagActive lorsque vous devez savoir si le flag est actif, sans avoir besoin de connaître la variation exacte reçue par le visiteur. Avec les règles Experiment, il est préférable d’appeler getVariation si vous avez au moins deux variations autres que off.