

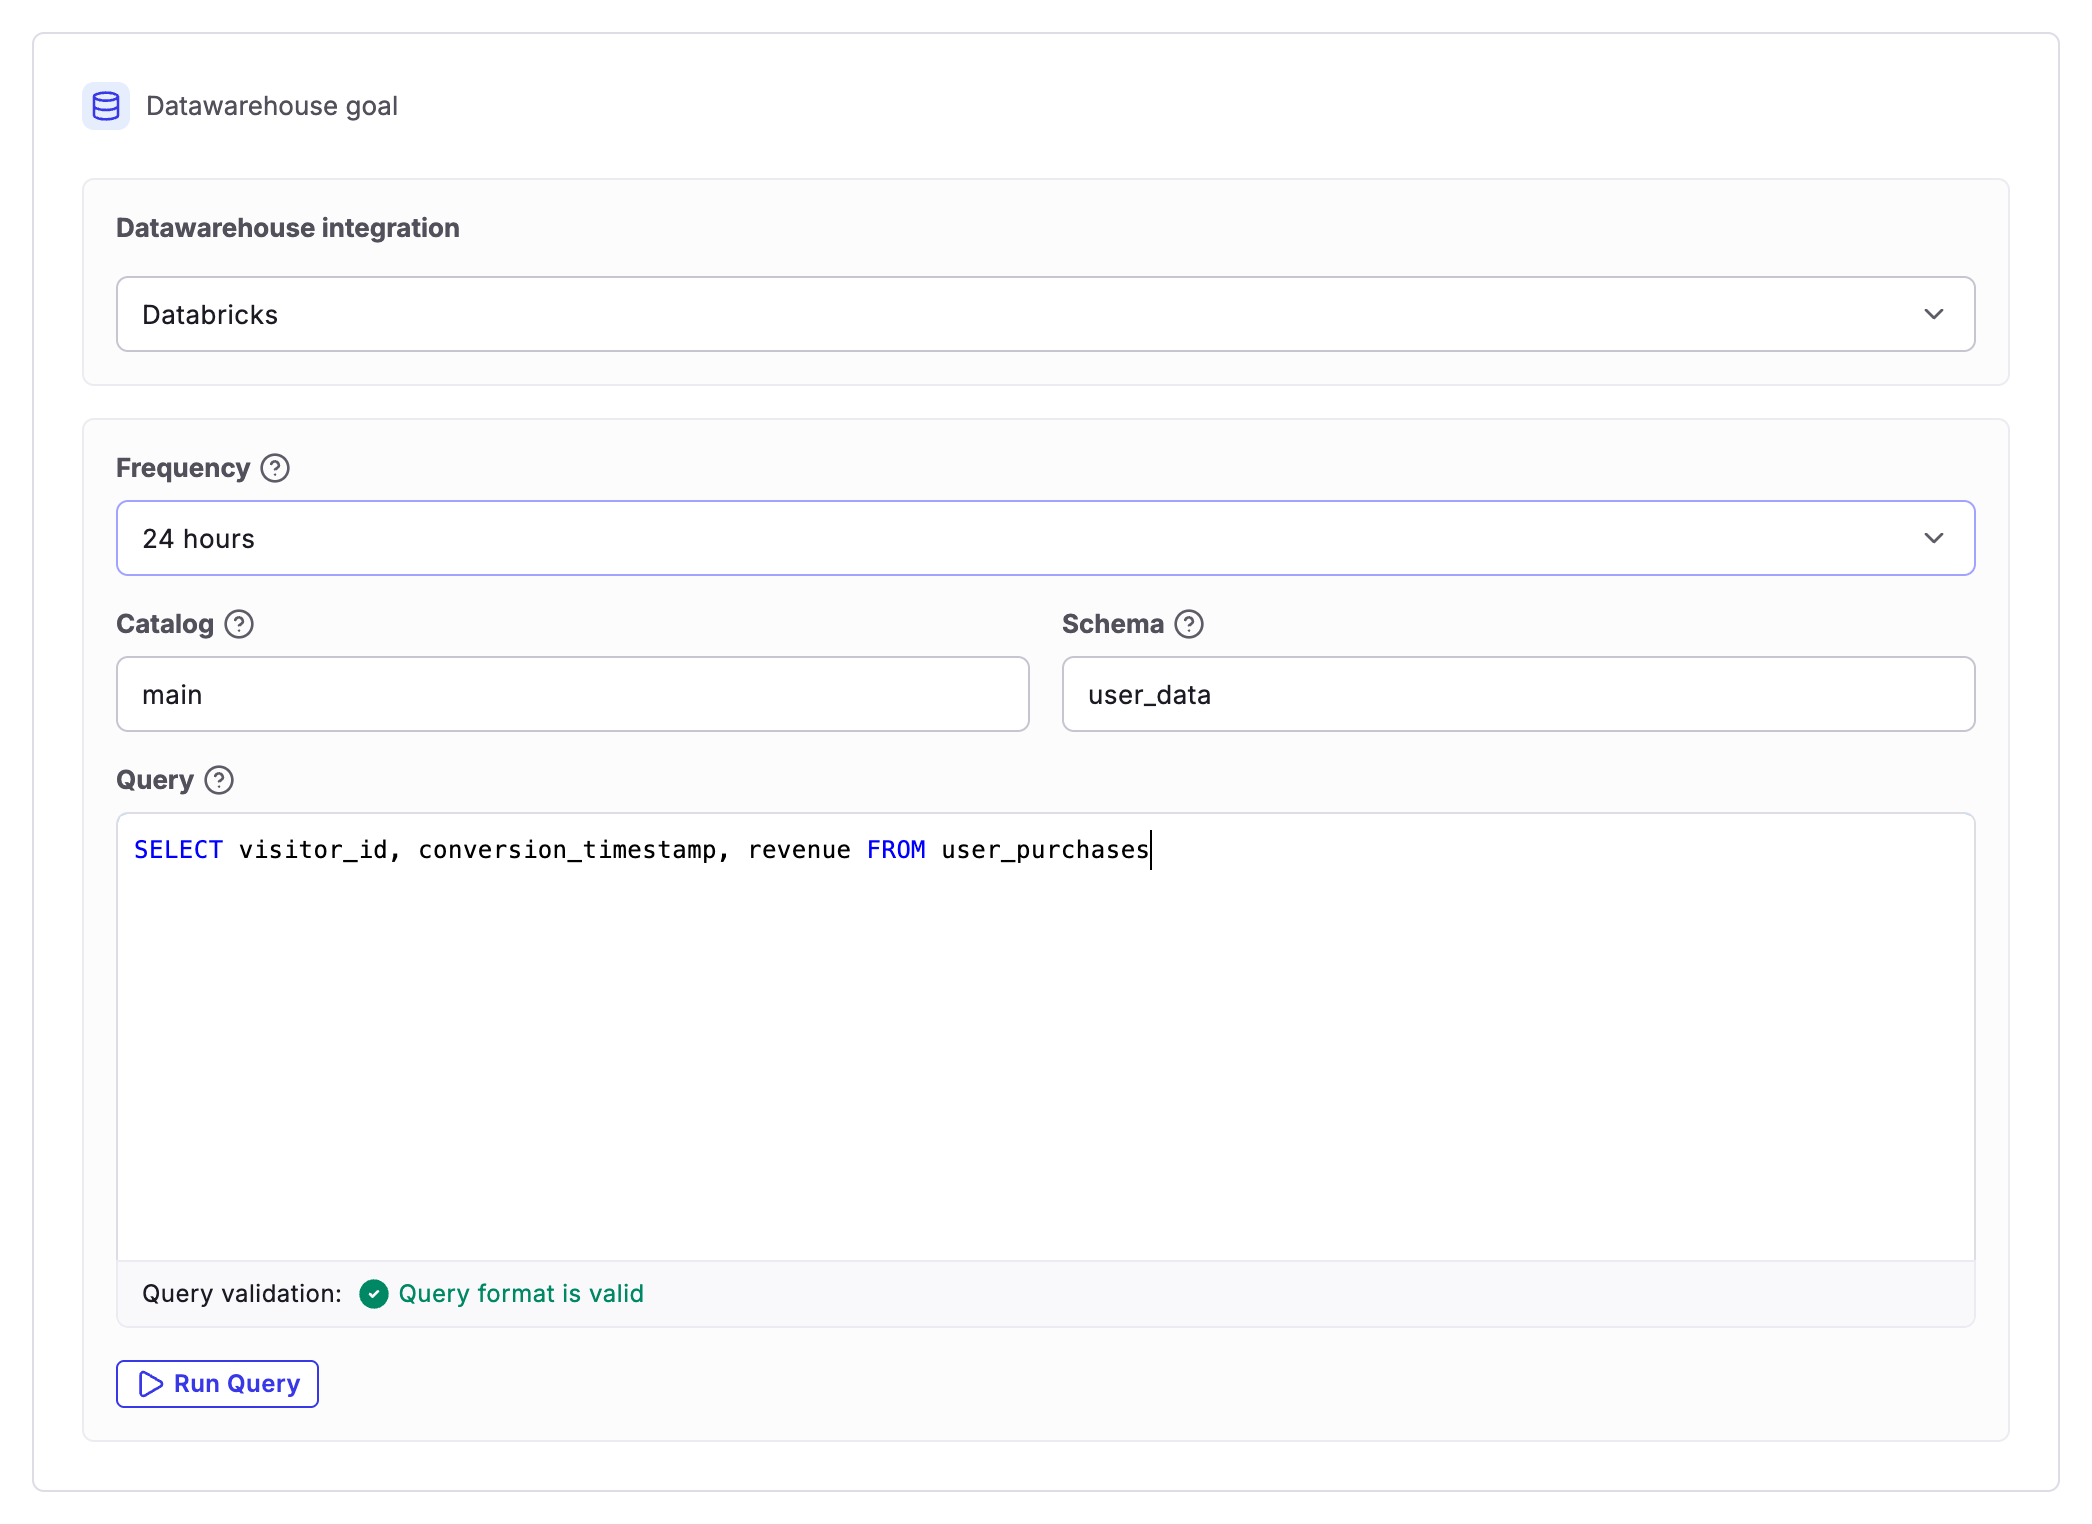
- Frequency:タスクを実行する頻度を選択します。
- Catalog:Kameleoonに読み取らせたいスキーマを含む Databricks カタログの名前を入力します。
- Schema:コンバージョンデータを含むスキーマを入力します。
- Query:Databricksから必要なデータを取得する SQL クエリを定義します。
クエリ形式
クエリは特定の形式に従う必要があります:visitor_idは訪問者の一意の IDを表す列で、conversion_timestampはコンバージョンが発生した正確な時刻を表す列です。Databricksでは、conversion_timestamp 列は Timestamp 型の列である必要があります。
各コンバージョンに収益を関連付けたい場合は、クエリを別の形式に従わせる必要があります:
revenueは、各コンバージョンの収益を含む列です。
より複雑なクエリの場合は、次のようにサブクエリを作成することで、この形式に従わせることができます:
Kameleoonがコンバージョンデータをポーリングする仕組み
Kameleoonは、ゴールの背後にある Databricksのコンバージョンデータを 1 時間ごとにポーリングし、タイムスタンプでフィルタリングするWITH 句をクエリに追加します。毎回イベント履歴全体を再読み込みする代わりに、Kameleoonは増分でポーリングします。各ポーリングジョブは、最後に成功したポーリング地点を記録し、次回の実行では、その地点以降の新しいレコードの時間枠だけをクエリします。Kameleoonは、すでにインポートしたデータを再スキャンしないため、この時間枠だけをクエリすることで、各ポーリングを高速に保てます。Kameleoonは、収集したコンバージョンを 1 日に 1 回、正午頃(CET)に実験結果にマージします。次回のマージまでは、Databricksゴールの直近 24 時間の数値がゼロと表示されることがあります。
ポーリングは常に前方へ進むため、最後に成功したポーリング時間枠よりも古いタイムスタンプで Databricksに書き込まれたレコードは、Kameleoonが取りこぼす可能性があります。レコードの到着が遅れるのは、通常、データパイプラインがコンバージョンイベントを書き込むのに時間がかかるためです。そのため、Kameleoonがレコードの属する時間枠をすでに過ぎてポーリングした後に、そのレコードが Databricksに届きます。取りこぼしを防ぐには、インジェスチョン時間枠を、パイプラインの通常の到着遅延に合わせて設定します。
インジェスチョン時間枠
デフォルトでは、Kameleoonは、ゴールのコンバージョンイベントが発生してから Databricks ウェアハウスで利用可能になるまでに、最大 1 時間の遅延を許容します。ポーリング時間枠は、この遅延を自動的に考慮します。パイプラインがバッチ処理や夜間の ETL ジョブなどにより、イベントを Databricksに書き込むのに 1 時間を超える場合、到着が遅れたレコードはポーリング時間枠の外に出るため、取りこぼされます。パイプラインの実際の到着遅延に合わせて遅延を延長するには、カスタマーサクセスマネージャーにお問い合わせください。インジェスチョン前にクエリを実行する
インジェスチョンタスクを保存する前に、Kameleoonでクエリを直接テストできます。テストでは次のことができます。- 接続をリアルタイムで確認する。
- 認証情報とアクセス権が正しいことを確認すると、最初のデータインポートを待つことなく、問題をすぐに検出できます。
- データの構造とアクセシビリティを検証する。
Databricks ゴールを使用する
ゴールを作成したら、Kameleoon キャンペーンに組み込むことができます。実験またはパーソナライゼーションを設定するときにゴールを選択すると、Databricks データベース内の特定のコンバージョンを追跡および分析できます。Kameleoonは、これらのコンバージョンを 1 日に 1 回、正午頃(CET)に実験結果にマージします。 実験でゴールを設定する方法については、ゴールキャンペーンの設定を参照してください。データ保持
Databricksからインポートしたコンバージョンデータは、Kameleoonで訪問データになり、Kameleoonの標準のデータ保持ポリシーに従います。保持期間については、データ保持ポリシーを参照してください。訪問者データの削除
Data API エンドポイントPOST /visit/forgetを使用すると、Kameleoonが保持する訪問者データを削除できます。このエンドポイントには認証が必要です。リクエストの形式については、Remove data for several visitorsを参照してください。このエンドポイントは、Databricks ワークスペース内のテーブルを削除しません。