

Databricksをデスティネーションとして有効化する
Databricksをデスティネーションとして有効化するには:- Use Databricks as a destinationをクリックします。
- Databricks catalog:書き込み先の Kameleoon スキーマを含む Databricksの「カタログ」(最上位のフォルダ)の名前です。
- Schema:Kameleoonがイベントテーブルを書き込むスキーマです(例:
kameleoon_events)。

「Use Databricks as a destination」の動作
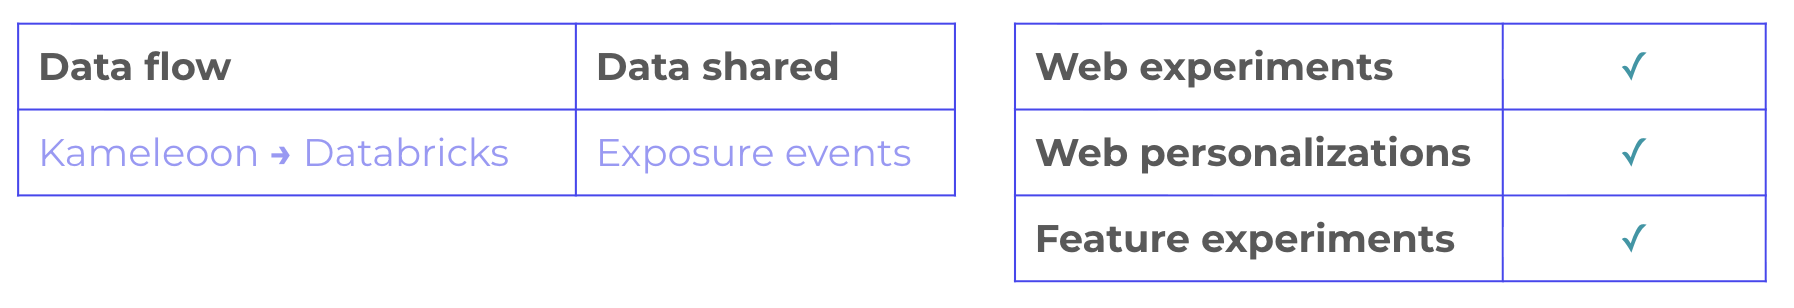
Use Databricks as a destinationを有効にすると、Kameleoonはすべての実験の露出を Databricksに書き込みます。 Kameleoonは、Databricks カタログのkameleoon_events スキーマにイベントを保存します。このカタログは、Databricksのセットアップで設定したもので、Kameleoonの service principalに書き込みアクセス権が付与されています。Kameleoonは、kameleoon_experiment_eventという名前のテーブルにデータを保存し、各露出を 1 行として書き込みます。これらの行を Databricksが保持する期間は、お客様の Databricks 設定で制御されます。
露出が Databricksのテーブルに届くまでには 2 つの手順があります。Web、モバイル、またはサーバー SDKが露出のペイロードを Kameleoonの Ingestion APIに送信し、Kameleoonがその後、認証済みの INSERTによってデータを Databricksに書き込みます。
Kameleoonは露出イベントのコピーを保持せず、各イベントをDatabricksに書き出すだけです。そのため、書き込みに失敗するとそのイベントは失われます。Kameleoonは失敗した書き込みを再試行せず、書き込みが失敗しても通知を送信しません。
このテーブルの SQL スキーマは次のとおりです。
custom_visitor_idは、設定されている場合、クロスデバイスリコンシリエーションのカスタムデータから Kameleoonが読み取ります。