

データウェアハウス統合は、Kameleoon の Web Experimentation および Feature Experimentation モジュールのプレミアムアドオンとして利用できます。詳細については、カスタマーサクセスマネージャーにお問い合わせください。
visitor_id 列と conversion_timestamp 列を返す必要があり、データは各イベントの後少なくとも 72 時間、クエリ可能な状態を保つ必要があります。
ゴールを作成する前に、プロジェクトで BigQuery 統合を有効化してください。
BigQuery ゴールを作成する
BigQuery からコンバージョンを読み取るゴールを作成するには、ゴールの作成 にある Data warehouse tracking フローに従い、Datawarehouse integration ドロップダウンから BigQuery を選択します。Step 1 では、次の BigQuery 固有のフィールドを入力します:- Frequency: Kameleoon がゴールデータを更新する頻度を定義します。
- BigQuery project ID: BigQuery プロジェクトの ID を入力します。
- Region: 提供されたリストから適切なリージョンを選択します。
- Query: BigQuery から必要なデータを取得する SQL クエリを定義します。
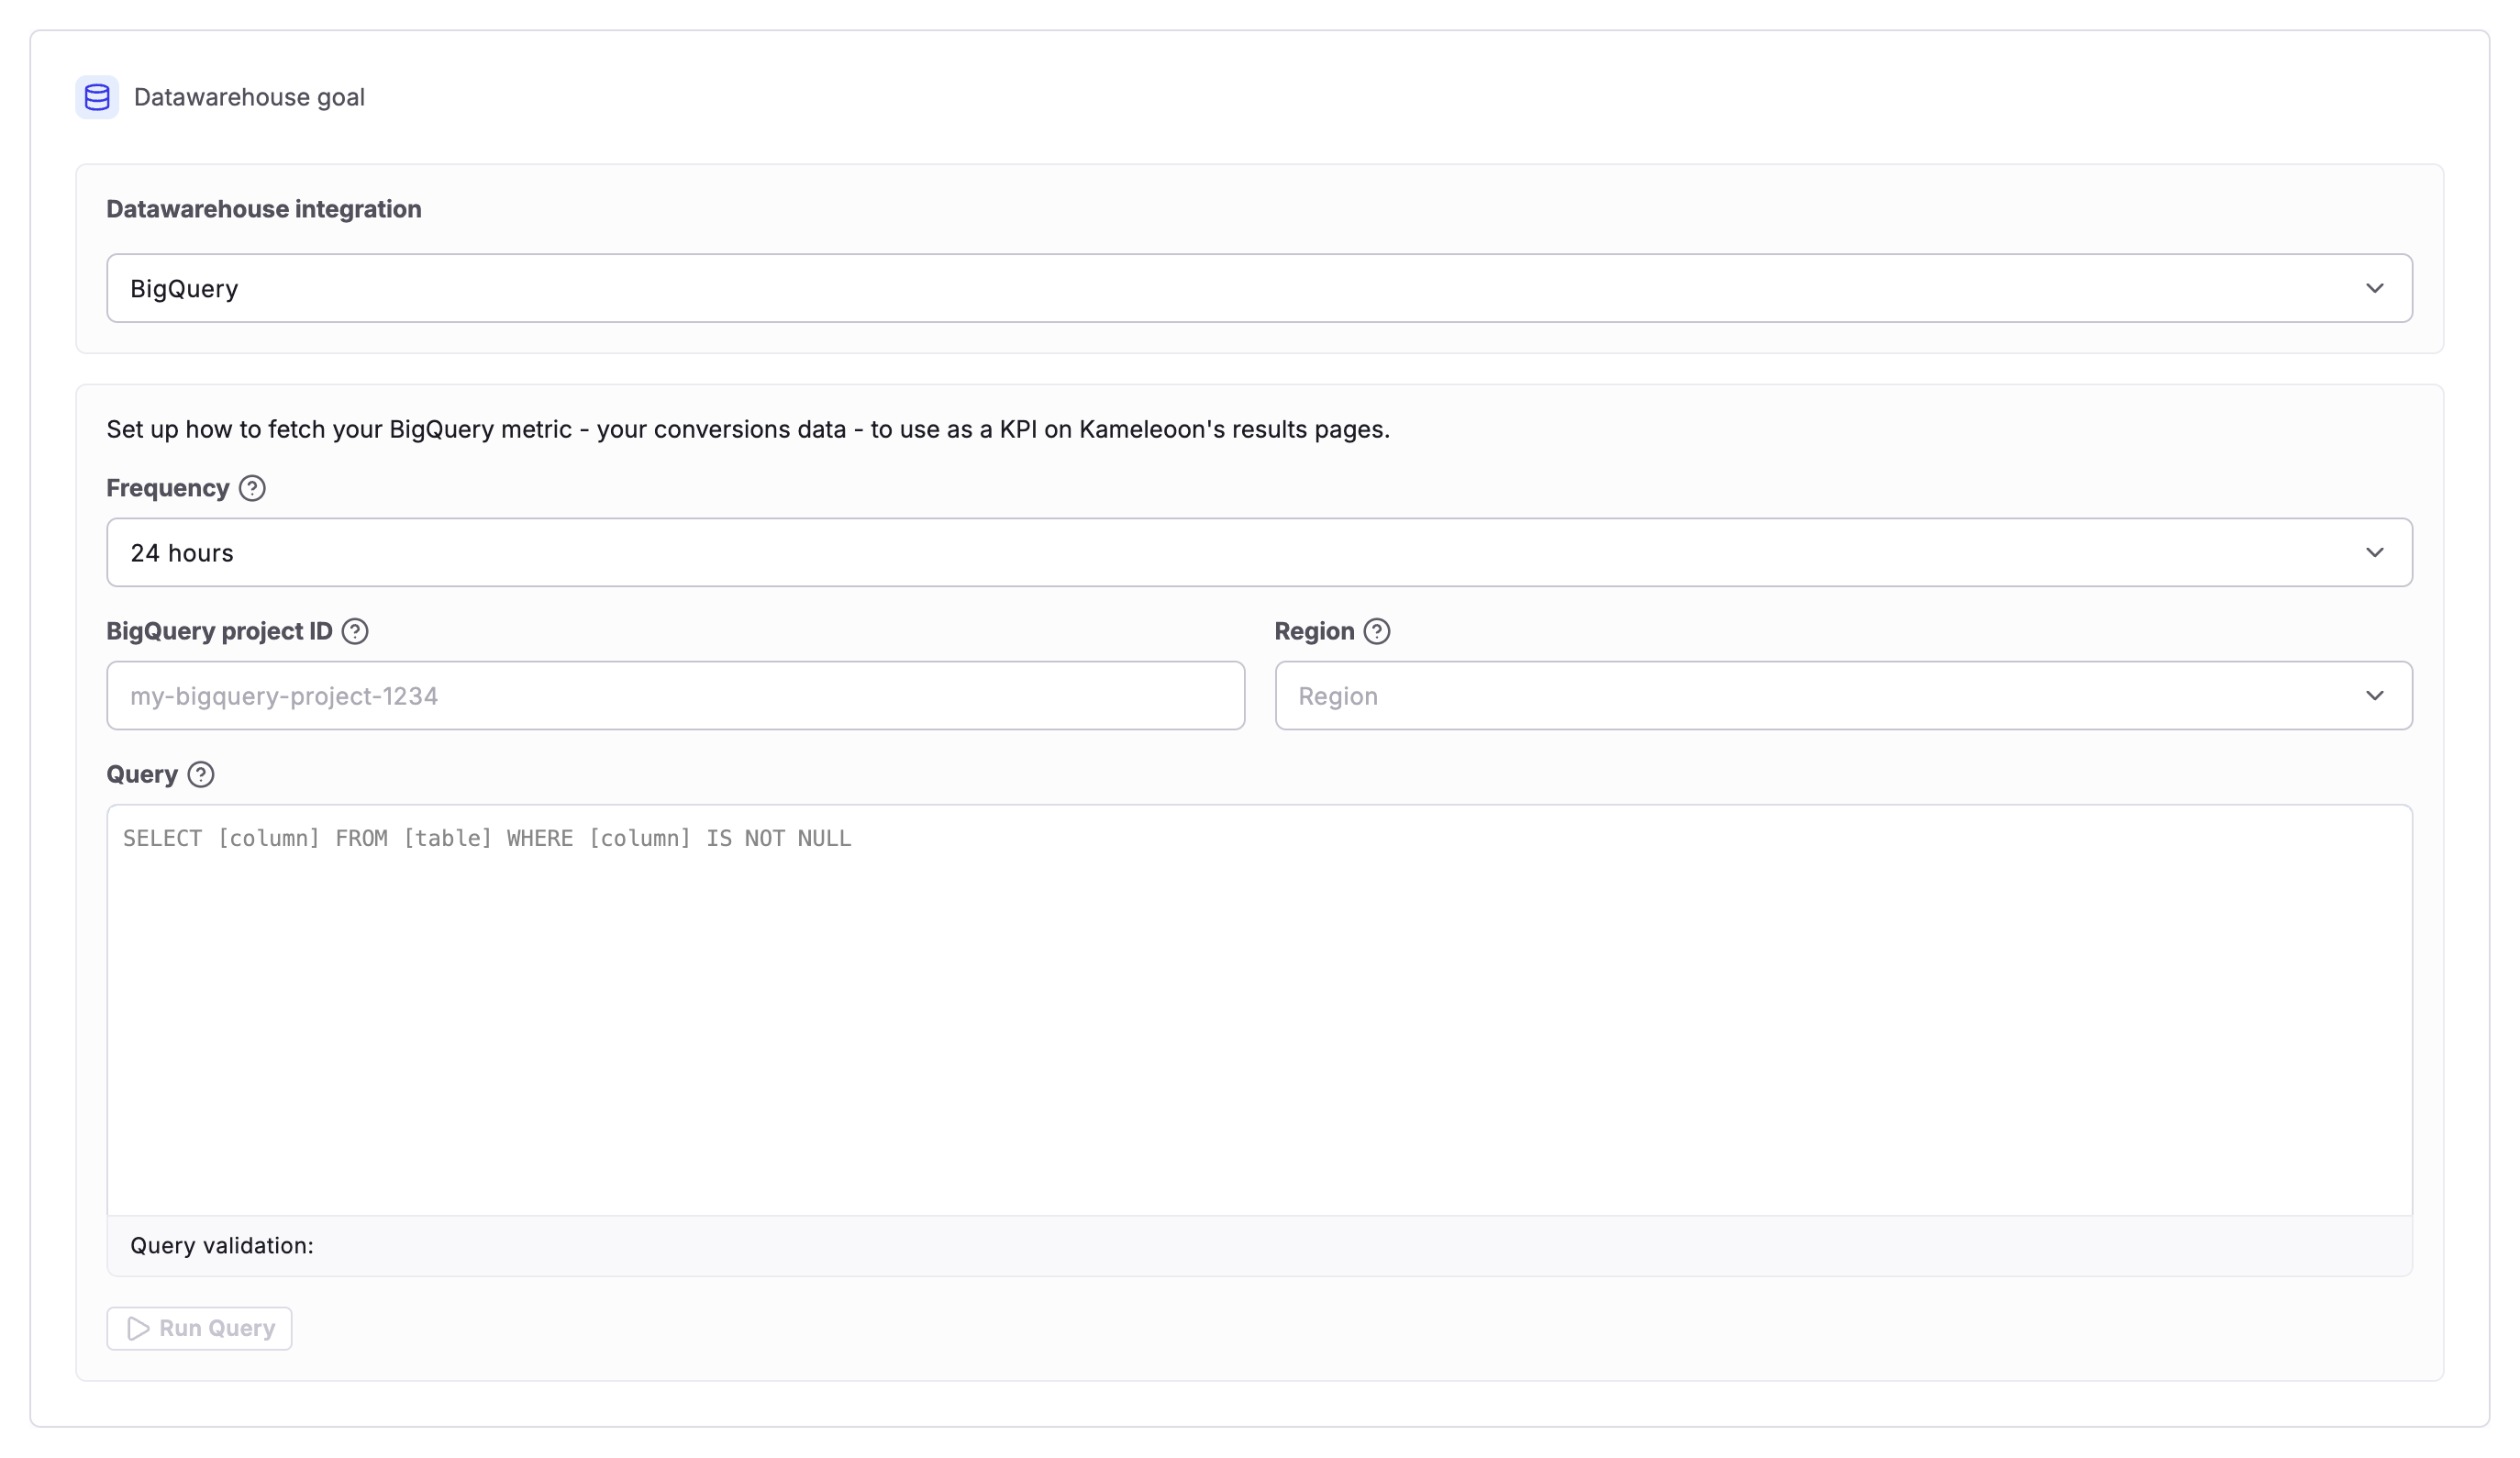
クエリ形式
クエリは特定の形式に従う必要があります:SELECT visitor_id, conversion_timestamp FROM your_events_table
ここで、visitor_id は訪問者の一意の ID を表す列で、conversion_timestamp はコンバージョンが発生した正確な時刻を表す列です。BigQuery では、conversion_timestamp 列は Timestamp 型である必要があります。
各コンバージョンに収益を関連付ける場合、クエリは次の別の形式に従う必要があります:
SELECT visitor_id, conversion_timestamp, revenue FROM your_events_table
ここで、revenue は各コンバージョンの収益を含む列です。
より複雑なクエリの場合は、元のクエリをサブクエリでラップすると、この形式を維持できます:
Kameleoon がコンバージョンデータをポーリングする仕組み
Kameleoon は、ゴールの背後にある BigQuery のコンバージョンデータを 1 時間ごとにポーリングします。その際、タイムスタンプでフィルタリングするWITH 句をクエリに追加します。イベント履歴全体を毎回再読み込みするのではなく、Kameleoon は増分でポーリングします。各ポーリングジョブは直前に成功したポーリング地点を記録し、次回の実行では、その地点以降に追加された新しいレコードの時間枠のみをクエリします。この時間枠だけをクエリすることで、Kameleoon はすでに取り込んだデータを再スキャンせず、各ポーリングを高速に保ちます。コンバージョンは 1 時間ごとに収集されますが、実験結果へのマージは 1 日に 1 回だけです。
ポーリングは常に前方へ進むため、直前に成功したポーリング時間枠より古いタイムスタンプで BigQuery に到着したレコードを、Kameleoon が取りこぼす場合があります。遅延したレコードは通常、データパイプラインがコンバージョンイベントを書き込むのに時間がかかるために発生します。その結果、Kameleoon がすでにそのレコードの属する時間枠を通過した後に、レコードが BigQuery に到達します。レコードの取りこぼしを防ぐには、Customer Success Manager に依頼して、取り込みの時間枠をパイプラインの通常の到着遅延に合わせて延長してください。
Kameleoon は、遅延したレコードを、そのタイムスタンプがまだポーリングしていない時間枠に含まれる場合にのみインポートします。ポーリング地点が 1 日を超えて進むと、Kameleoon はその日を再読み込みしないため、その日の遅延レコードや修正された行はインポートしません。
インジェスチョン時間枠
デフォルトでは、Kameleoon は、ゴールのコンバージョンイベントが発生してから BigQuery ウェアハウスで利用可能になるまで最大 1 時間を許容します。ポーリング時間枠は、この遅延を自動的に考慮します。パイプラインがバッチ処理や夜間の ETL ジョブなどにより、イベントを BigQuery に書き込むのに 1 時間以上かかる場合、遅延したレコードはポーリング時間枠の外に出るため、取りこぼされます。遅延時間をパイプラインの実際の到着遅延に合わせて延長するには、Customer Success Manager に問い合わせてください。ポーリングの失敗とスキーマ変更
ポーリングが失敗しても、ポーリング地点は元の位置に留まります。ポーリング地点とは、Kameleoon がレコードのインポートを完了している時点を指します。そのため、次回のスケジュールされたポーリングは同じ地点から開始し、同じ時間枠を再試行します。Kameleoon は、クエリが再び実行されたときに、その時間枠のレコードをインポートします。 スキーマ変更が結果に与える影響は、変更の内容によって 2 通りあります:- クエリが想定している列が欠落している、または名前が変更されている場合: ポーリングは失敗し、Kameleoon は失敗をログに記録します。ポーリング地点は進まないため、クエリがテーブルと再び一致するまで、以降の実行は同じ時間枠を再試行します。
- 列名は変わらないが、その意味が変わった場合: ポーリングは成功し、ポーリング地点は進みます。Kameleoon は、同名の列が想定どおりに訪問者識別子、タイムスタンプ、収益を保持しているかを確認しないため、エラーが表示されないまま結果が誤る可能性があります。
訪問者識別子
Kameleoon はvisitor_id の値を使って、各コンバージョンの対象となる訪問者を特定します。そのため、その値は、Kameleoon がその訪問者についてすでに持っている識別子と一致する必要があります。デフォルトでは、値は Kameleoon 訪問者コードです。クロスデバイス履歴調整を設定している場合、Kameleoon は visitor_id を訪問者コードではなく、クロスデバイス履歴調整の一意の識別子としてフラグを設定したカスタムデータと照合します。
取り込み前にクエリを実行する
ゴールを保存する前に、Kameleoon でクエリを直接テストできます。テストにより次のことができます:- 接続をリアルタイムで確認できます。
- 認証情報とアクセス権が正しいことを確認でき、最初のデータインポートを待たずに問題をすぐに検出できます。
- データの構造とアクセシビリティを検証できます。
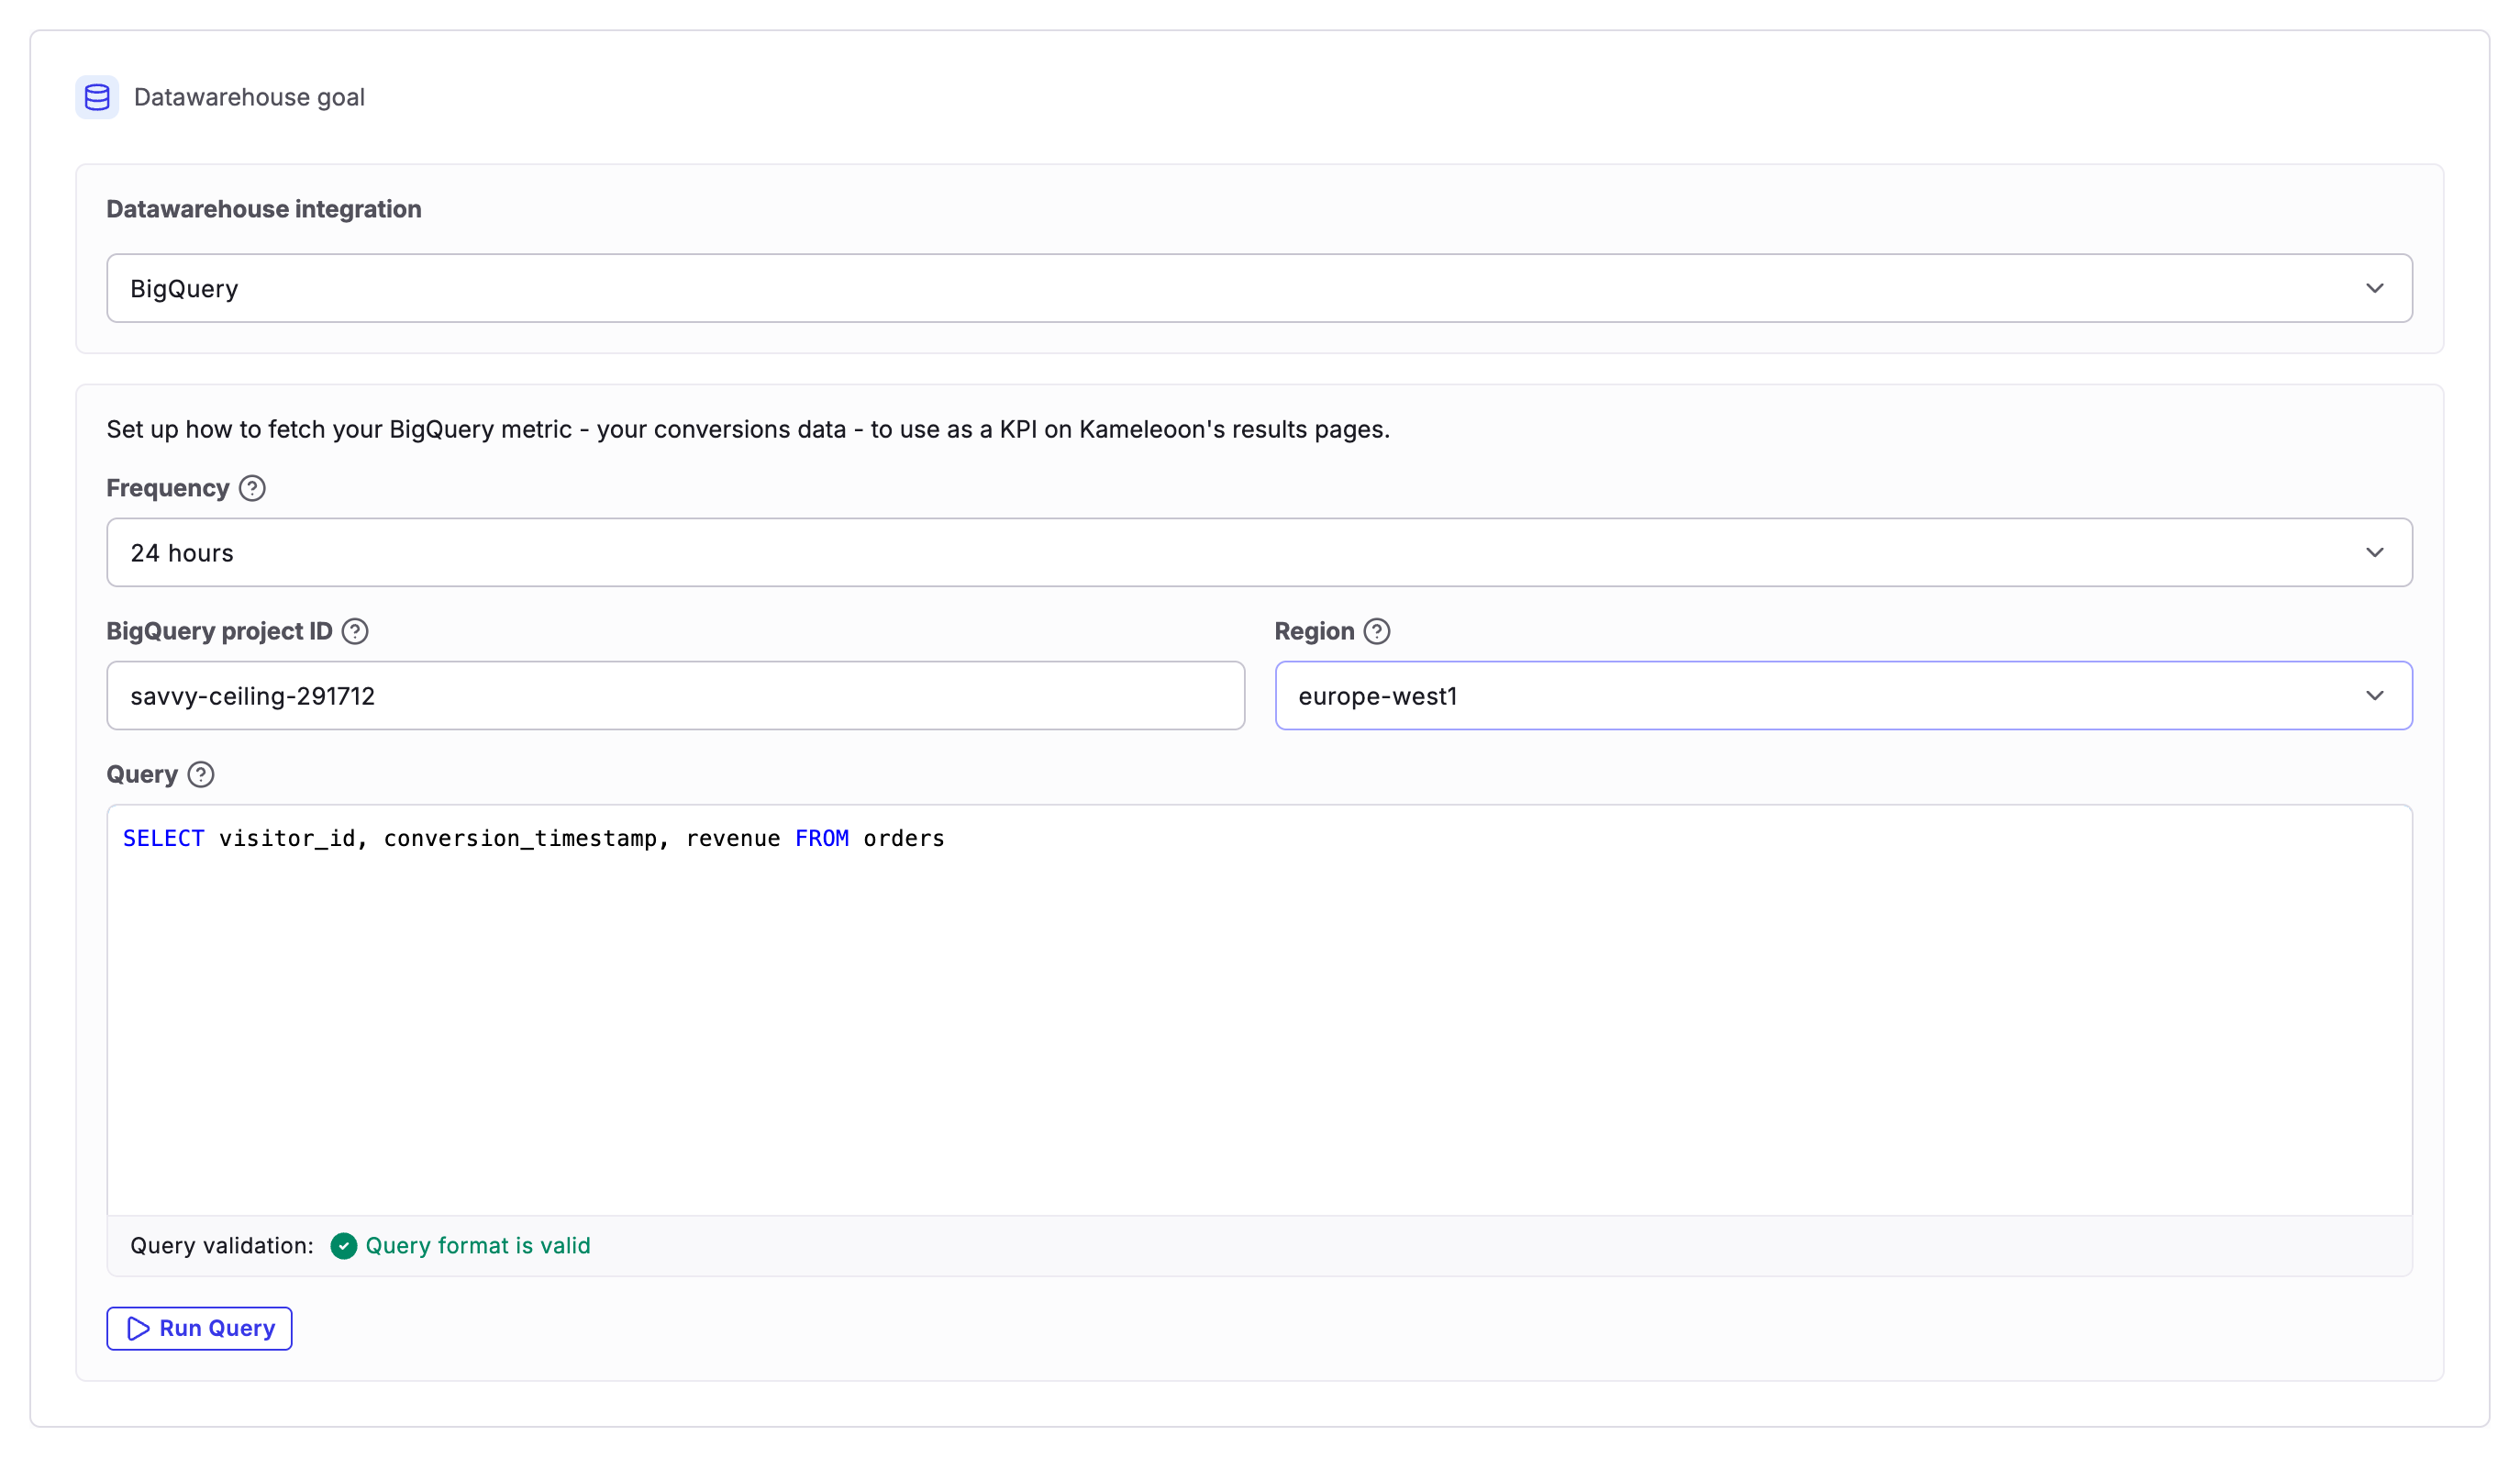
BigQuery ゴールの使用
ゴールを作成したら、Kameleoon のキャンペーンに組み込めます。実験またはパーソナライゼーションを設定するときに、ファイナライズページの Goals セクションでこのゴールを選択できます。そのゴールを使うと、BigQuery データベースの特定のコンバージョンを追跡および分析できます。 キャンペーンでゴールを設定する方法は、ゴールキャンペーンの設定 を参照してください。データ保持
BigQuery からインポートしたコンバージョンデータは、Kameleoon で訪問データになり、Kameleoon の標準のデータ保持ポリシーに従います。保持期間については、データ保持ポリシー を参照してください。訪問者データの削除
Data API エンドポイントPOST /visit/forget を使用して、Kameleoon が保持する訪問者データを削除できます。このエンドポイントには認証が必要です。リクエスト形式については、Remove data for several visitors を参照してください。このエンドポイントは、BigQuery プロジェクト内のテーブルを削除しません。