データウェアハウス統合は、Web Experimentation および Feature Experimentation モジュールのプレミアムアドオンとして利用できます。詳細については、カスタマーサクセスマネージャーにお問い合わせください。
アナリストがBigQueryで実験データをクエリする場合、Kameleoonの露出データは、ウェアハウスの残りのデータとは別に保管されています。Use BigQuery as a destinationをオンにすると、Kameleoonは各実験の露出イベントをBigQuery プロジェクト内のテーブルに書き込むため、アナリストはそこで作業できます。先にBigQuery をセットアップするを完了してください。セットアップでは「kameleoon」データセットが作成され、デスティネーション機能で使用するサービスアカウントへのアクセス権が付与されます。

BigQueryをデスティネーションとして有効化する

機能を有効にするには、プロジェクトでUse BigQuery as a destinationをオンにします。
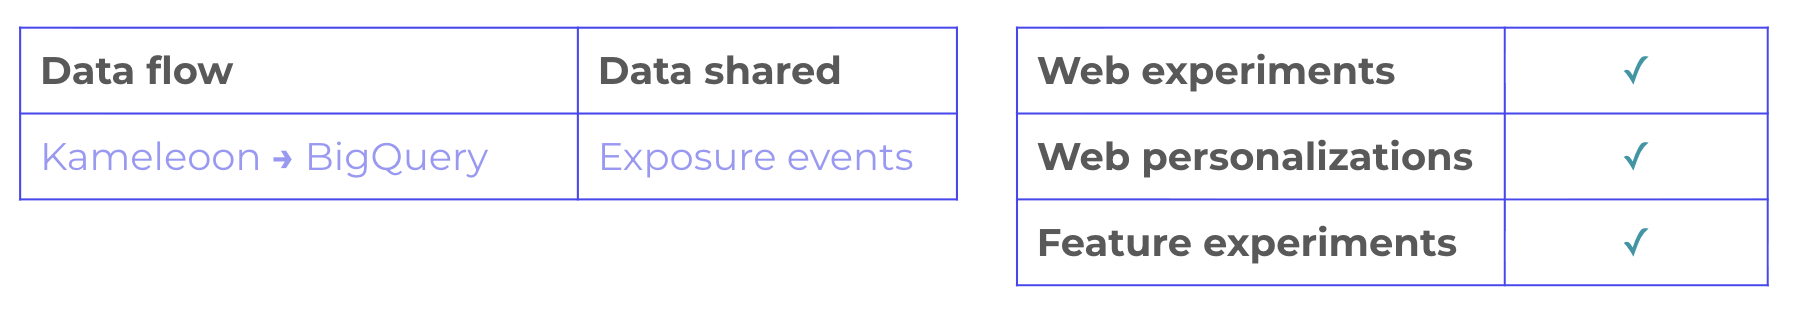
Kameleoon から BigQueryへのデータフローを示す表。共有データとして実験の露出イベントがあり、Web experiments、Web personalizations、Feature experimentsにチェックマークが付いている
次の手順に従ってください:
  1. 選択したプロジェクトの構成で、Use BigQuery as a destinationのラベルが付いたチェックボックスをオンにして、機能を有効にします。
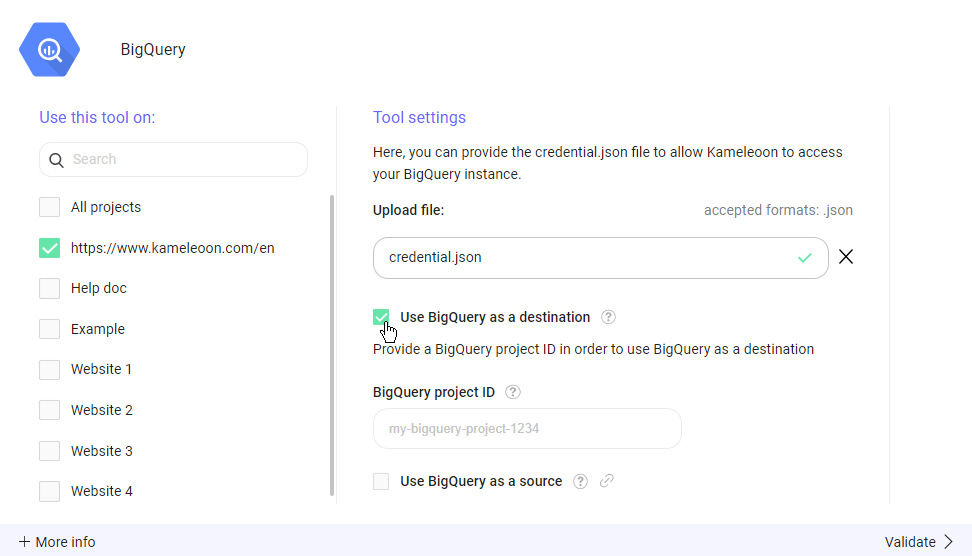
BigQuery 統合設定でUse BigQuery as a destinationがオンになっており、BigQuery project ID フィールドは空の状態になっている
  1. BigQuery project ID フィールドに、Google BigQuery プロジェクトのプロジェクト IDを入力します。
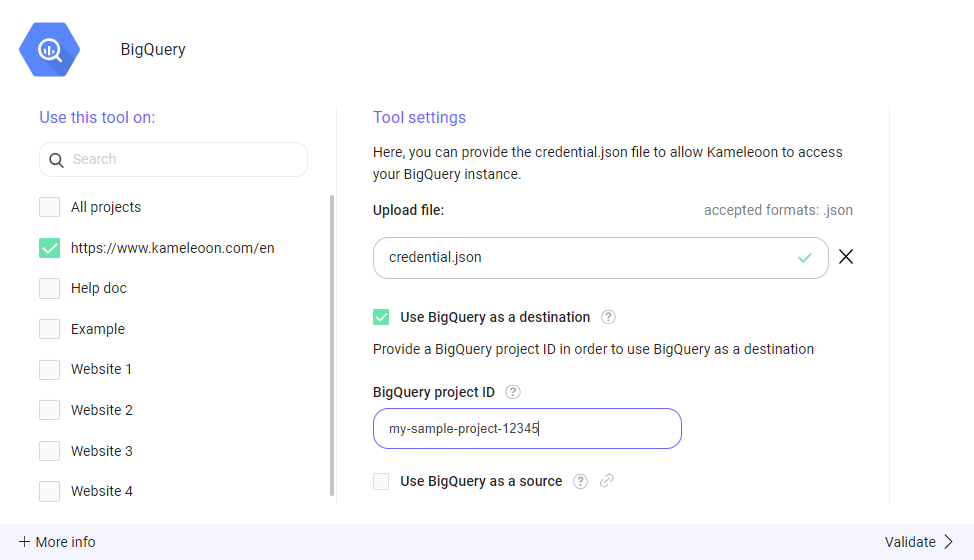
BigQuery 統合設定で、BigQuery project ID フィールドにサンプルのプロジェクト IDが入力されている
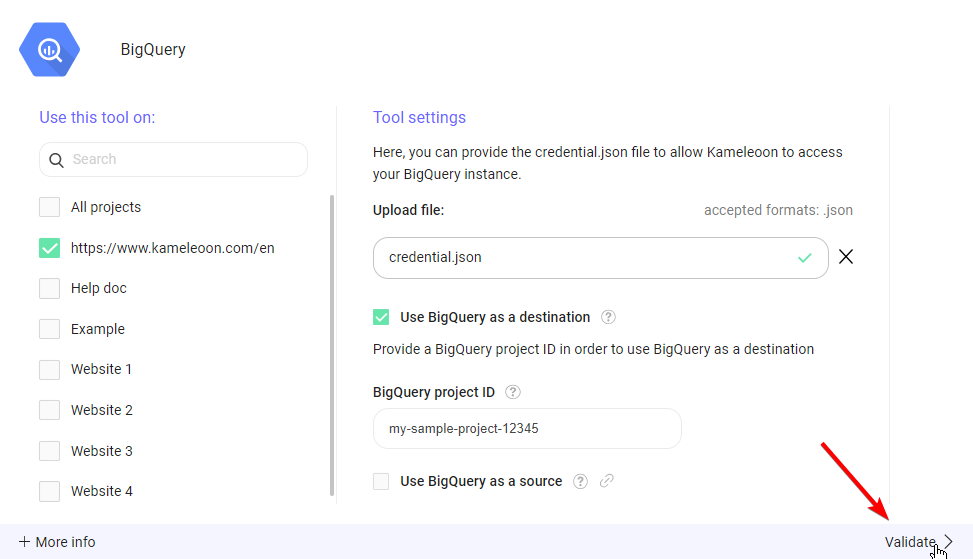
  1. Validateをクリックして変更を保存します。
BigQuery 統合設定の右下隅にValidate ボタンがあり、矢印で示されている
構成を保存すると、Kameleoonは各露出イベントをkameleoon_experiment_event テーブルに書き込みます。

「Use BigQuery as a destination」の機能

Kameleoonは、各実験の露出イベントを、「kameleoon」データセット内のkameleoon_experiment_eventという名前のテーブルに書き込みます。書き込みには、Kameleoon サービスアカウントに付与した書き込みアクセス権を使用します。テーブルのSQLスキーマは次のとおりです:
設定されている場合、Kameleoonはクロスデバイス履歴調整のカスタムデータから custom_visitor_idを読み取ります。