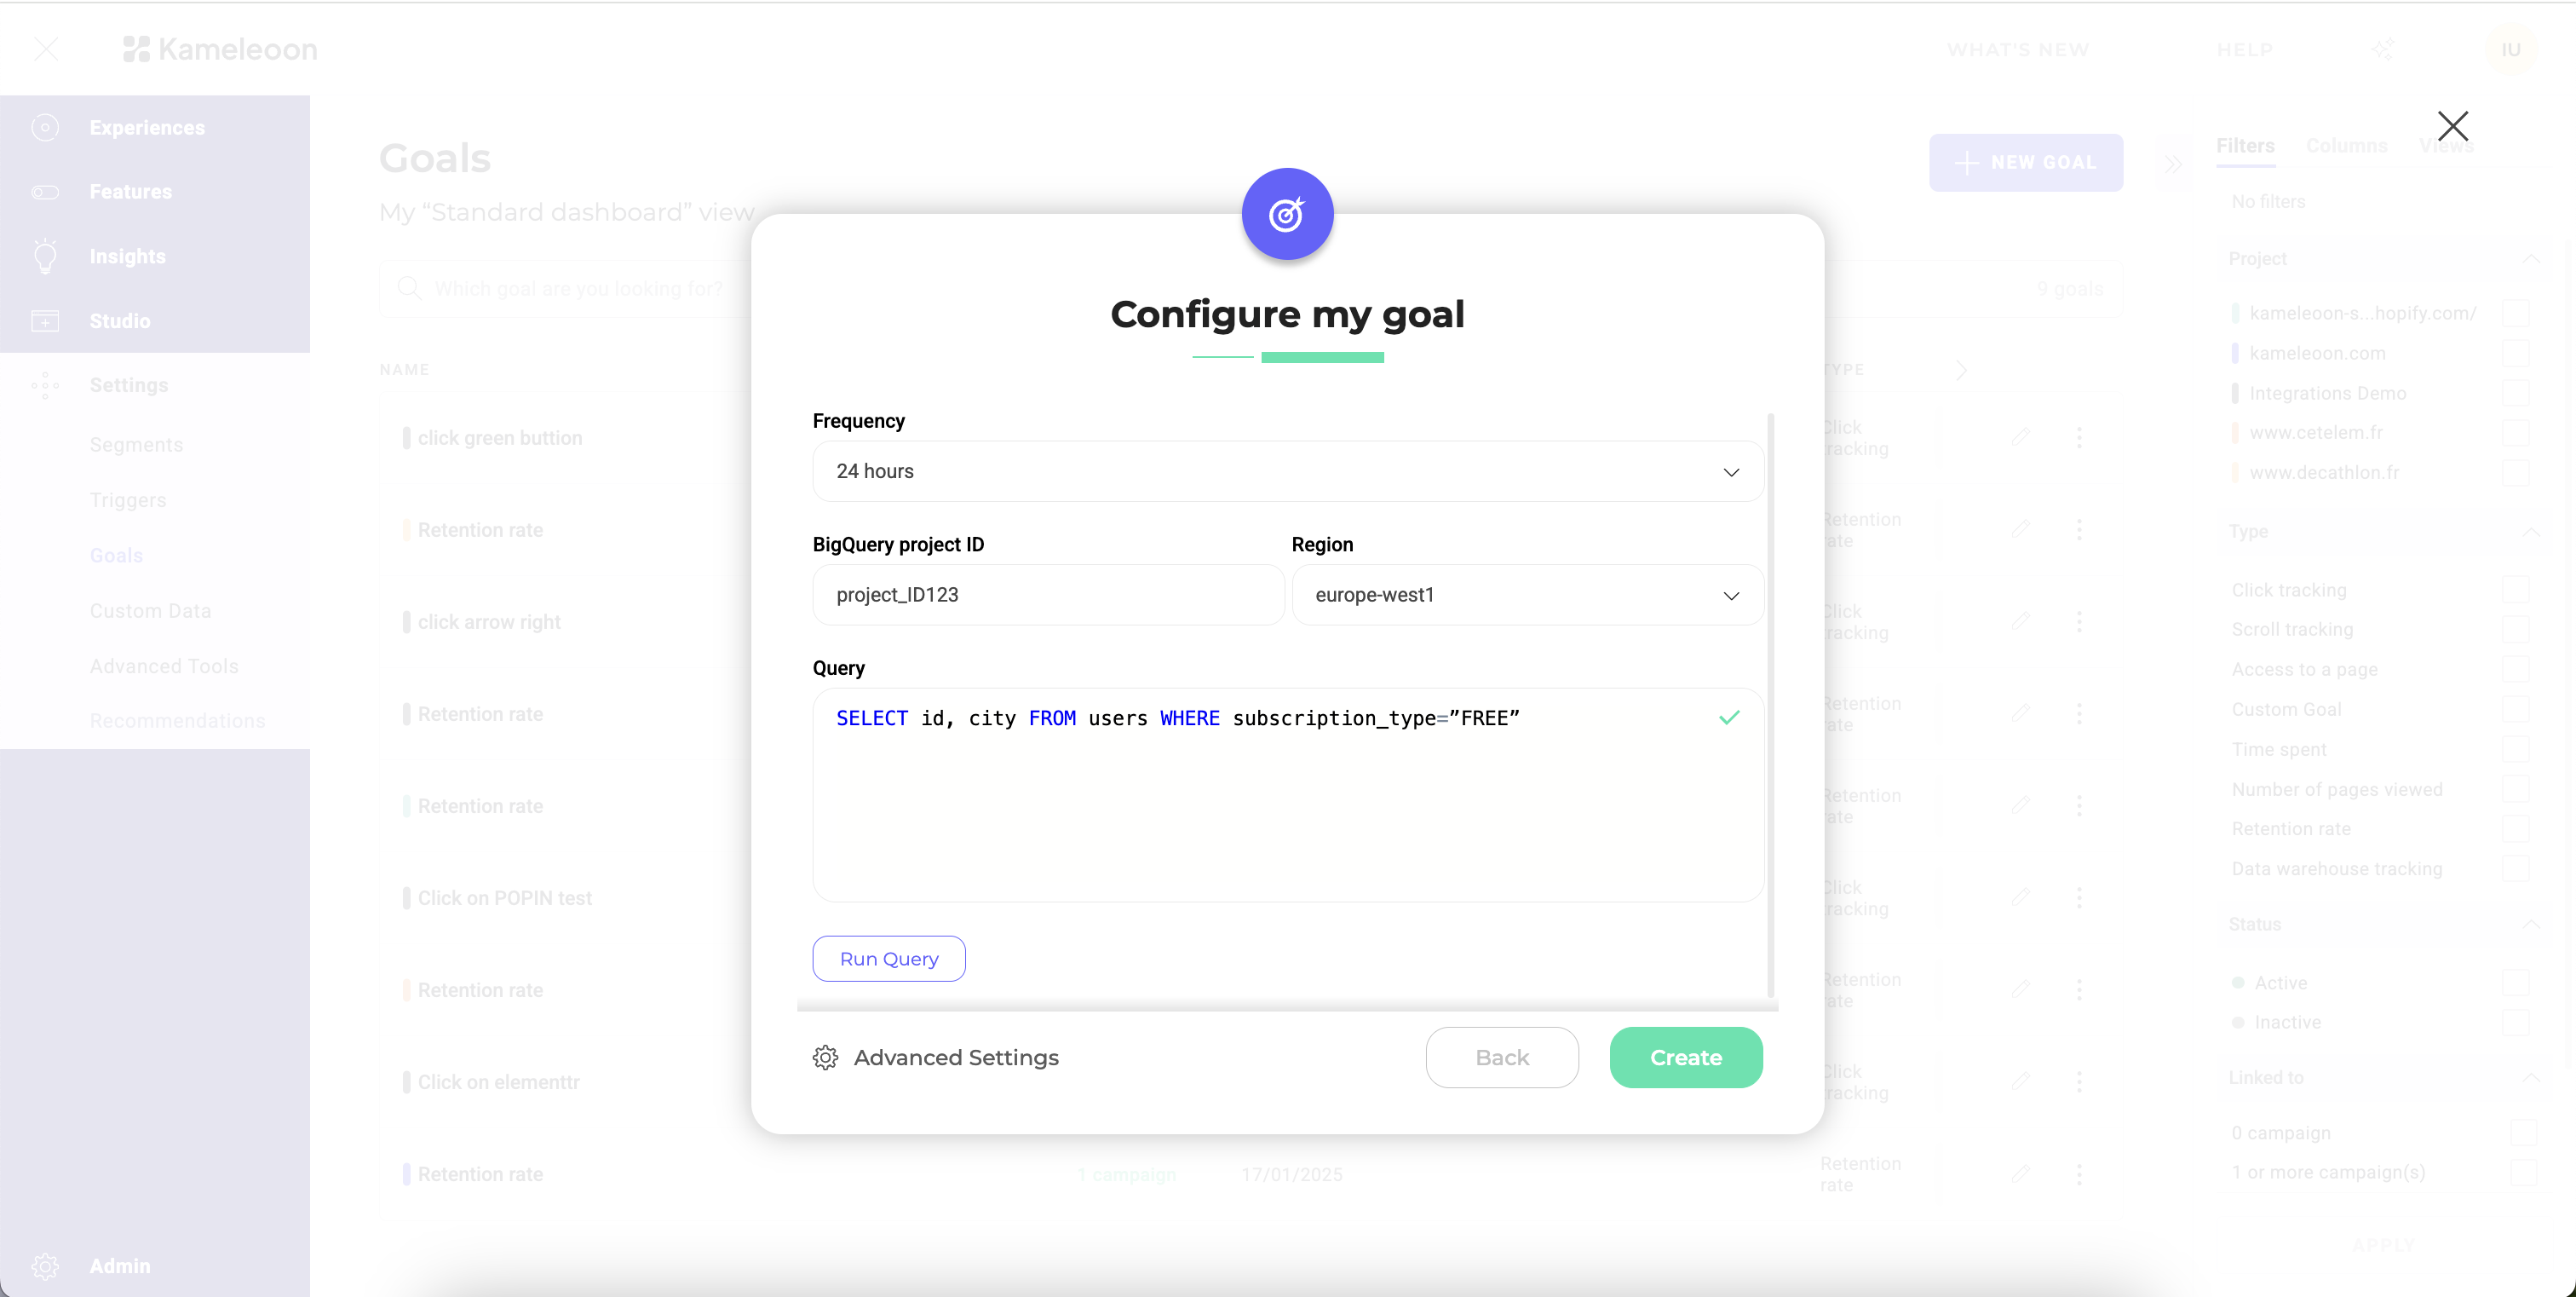
- Permite una recopilación de datos precisa, mejorando la segmentación de audiencias para campañas personalizadas según las necesidades y preferencias específicas de la audiencia.
- Configure Data Ingestion Tasks para extraer datos de Redshift de forma eficiente.
Las integraciones con data warehouses están disponibles como complemento premium para nuestros módulos Web Experimentation y Feature Experimentation. Para obtener más información, contacte a su Customer Success Manager.
- Redshift cluster type: Seleccione si su origen de Redshift utiliza un clúster Provisioned o un workgroup Serverless.
- Redshift cluster ID: Introduzca su ID de clúster de Redshift aprovisionado.
- Region: Introduzca la región apropiada.
- Database: Introduzca la base de datos que contiene sus datos de conversión.
- Frequency: Defina con qué frecuencia desea que Kameleoon actualice los datos del objetivo.
- Query: Defina la consulta SQL para recuperar los datos necesarios de Amazon Redshift.
Formato de la consulta
La consulta debe seguir un formato específico:SELECT visitor_id, conversion_timestamp FROM your_events_table
Donde visitor_id es la columna que representa el ID único de sus visitantes y conversion_timestamp es una columna que representa el momento exacto en que se produjo la conversión. En Amazon Redshift, la columna conversion_timestamp debe ser una columna de tipo Timestamp.
Si quiere asociar un ingreso a cada conversión, la consulta debe seguir un formato alternativo:
SELECT visitor_id, conversion_timestamp, revenue FROM your_events_table
Donde revenue es una columna que contiene los ingresos de cada conversión.
Para consultas más complejas, puede ajustarse a este formato formulando una subconsulta así:
SELECT visitor_id, conversion_timestamp, revenue FROM ( {your_original_query} ) AS subquery
Cómo Kameleoon consulta los datos de conversión
Kameleoon consulta los datos de conversión de Amazon Redshift de su objetivo cada hora, añadiendo a su consulta una cláusulaWITH que filtra por marcas de tiempo. En lugar de recargar todo el historial de eventos en cada ejecución, Kameleoon consulta de forma incremental: cada tarea de consulta registra el último punto de consulta correcto y, en la siguiente ejecución, solo consulta la ventana temporal de los registros nuevos desde ese punto. Consultar solo esa ventana mantiene cada consulta rápida, ya que Kameleoon nunca vuelve a escanear datos que ya ha importado. Aunque las conversiones se recopilan cada hora, solo se fusionan en los resultados de su experimento una vez al día.
Como la consulta siempre avanza hacia delante, Kameleoon puede pasar por alto un registro que llega a Amazon Redshift con una marca de tiempo anterior a la última ventana de consulta correcta. Los registros tardíos suelen llegar porque su pipeline de datos tarda en escribir el evento de conversión, de modo que el registro llega a Amazon Redshift solo después de que Kameleoon ya haya consultado más allá de la ventana temporal a la que pertenece. Para evitar registros perdidos, configure el plazo de ingesta que aparece a continuación para que coincida con el retraso de llegada habitual de su pipeline.
Plazo de ingesta
Por defecto, Kameleoon permite hasta 1 hora entre el momento en que se produce un evento de conversión de su objetivo y el momento en que está disponible en su warehouse de Amazon Redshift, y su ventana de consulta tiene en cuenta ese retraso automáticamente. Si su pipeline tarda más de 1 hora en escribir eventos en Amazon Redshift, por ejemplo debido a procesos ETL por lotes o nocturnos, esos registros de llegada tardía quedan fuera de la ventana de consulta y se pierden. Póngase en contacto con su Customer Success Manager para ampliar el retraso de modo que coincida con el retraso de llegada real de su pipeline.Ejecutar su consulta antes de la ingesta
Antes de guardar su ingestion task, puede probar su consulta directamente en Kameleoon. Las pruebas le permiten:- Verificar la conexión en tiempo real.
- Confirmar que sus credenciales y derechos de acceso son correctos, lo que ayuda a detectar problemas de inmediato, sin tener que esperar a la primera importación de datos.
- Validar la estructura y accesibilidad de sus datos.