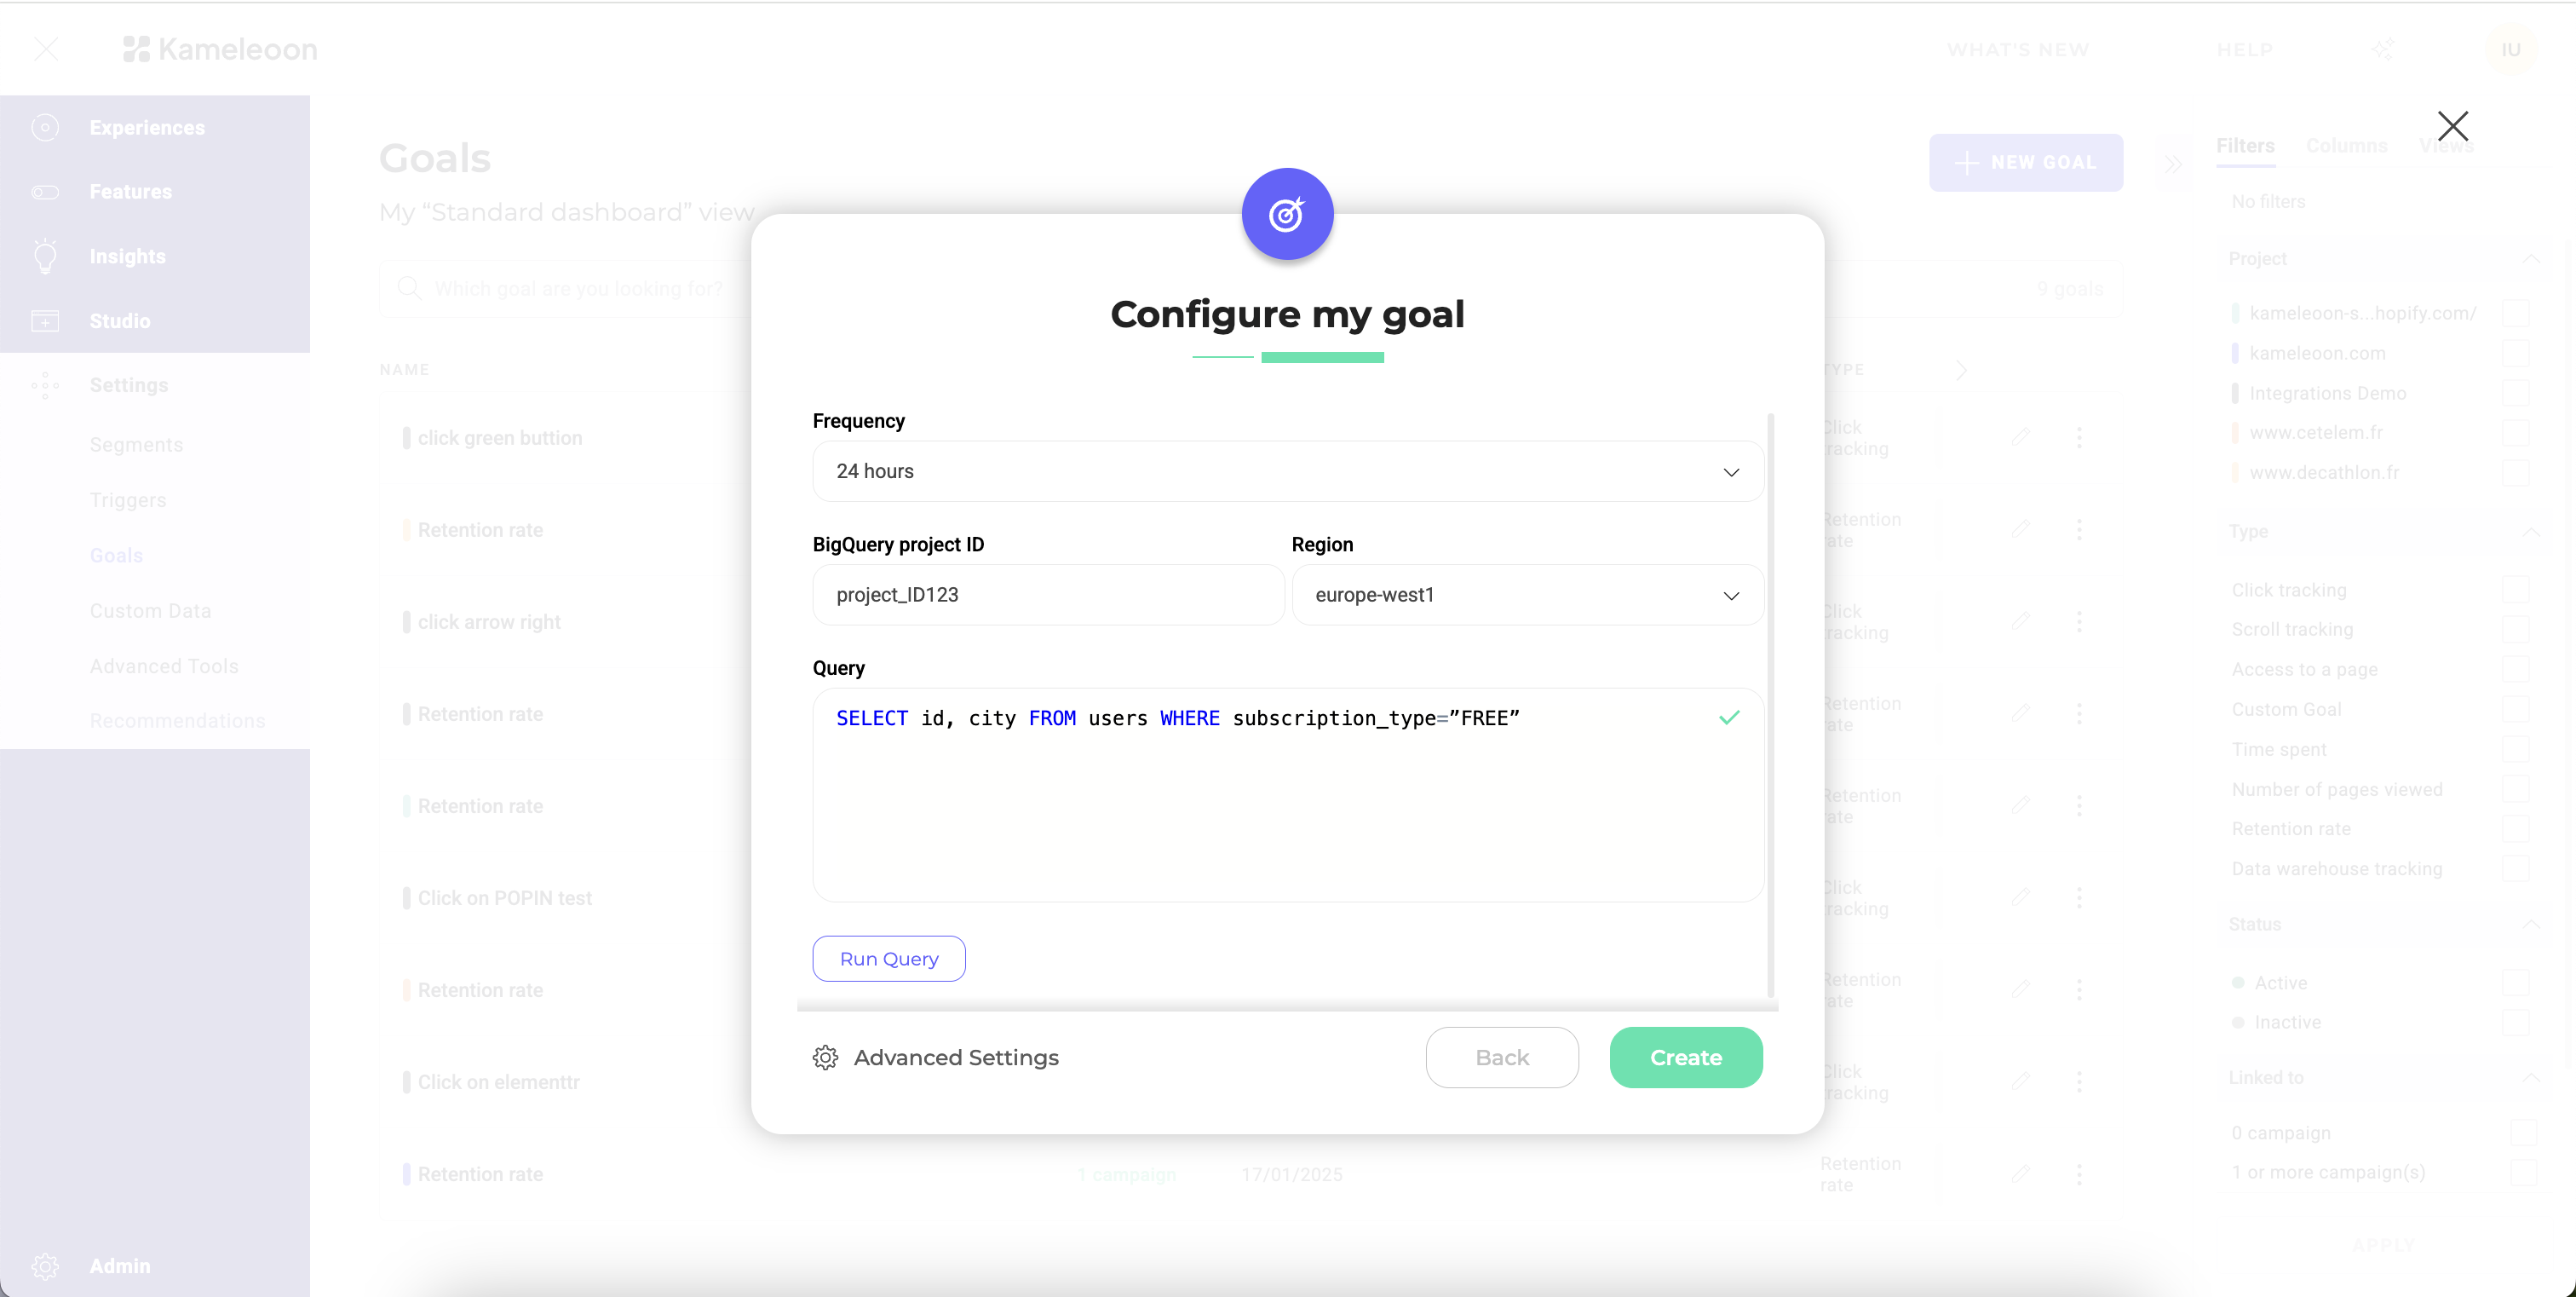
- Frequency: Wählen Sie aus, wie häufig die Aufgabe ausgeführt werden soll.
- Catalog: Geben Sie den Namen des Databricks-Katalogs ein, der die Schemata enthält, aus denen Kameleoon lesen soll.
- Schema: Geben Sie das Schema ein, das Ihre Konversionsdaten enthält.
- Query: Geben Sie eine SQL-Abfrage mit zwei Spalten ein – die erste Spalte sollte die Benutzer-ID (oder
kameleoonVisitorCode) enthalten, die zweite den entsprechenden Wert, den Sie als zusätzliche Information (Anreicherung) für diesen Benutzer hinzufügen möchten.
Aufbewahrungsdauer des Data Warehouse: Damit ein Ereignis abgefragt werden kann, verlangt Kameleoon, dass es nach seinem Auftreten mindestens 72 Stunden lang über Ihre Eingabeabfrage zugänglich bleibt.
Abfrageformat
Die Abfrage muss einem bestimmten Format entsprechen:visitor_id die Spalte, die die eindeutige ID Ihrer Besucher darstellt, und conversion_timestamp eine Spalte, die den genauen Zeitpunkt darstellt, zu dem die Konversion stattgefunden hat. In Databricks muss die Spalte conversion_timestamp vom Typ Timestamp sein.
Wenn Sie jeder Konversion einen Umsatz zuordnen möchten, sollte die Abfrage einem alternativen Format entsprechen:
revenue eine Spalte, die den Umsatz für jede Konversion enthält.
Für komplexere Abfragen können Sie dieses Format einhalten, indem Sie eine Unterabfrage wie folgt formulieren:
Wie Kameleoon Konversionsdaten abfragt
Kameleoon fragt die Databricks-Konversionsdaten hinter Ihrem Ziel jede Stunde ab und fügt Ihrer Abfrage eineWITH-Klausel hinzu, die nach Zeitstempeln filtert. Anstatt bei jedem Lauf den gesamten Ereignisverlauf neu zu laden, fragt Kameleoon inkrementell ab: Jeder Abfragejob merkt sich den letzten erfolgreichen Abfragepunkt und fragt beim nächsten Lauf nur das Zeitfenster der neuen Datensätze seit diesem Punkt ab. Da nur dieses Fenster abgefragt wird, bleibt jede Abfrage schnell, weil Kameleoon bereits importierte Daten nie erneut scannt. Beachten Sie, dass Konversionen zwar stündlich erfasst, jedoch nur einmal täglich in Ihre Experimentergebnisse eingebunden werden.
Da die Abfrage immer vorwärts fortschreitet, kann Kameleoon einen Datensatz übersehen, der mit einem Zeitstempel in Databricks eintrifft, der älter ist als das letzte erfolgreiche Abfragefenster. Verspätete Datensätze entstehen meist, weil Ihre Datenpipeline Zeit benötigt, um das Konversionsereignis zu schreiben, sodass der Datensatz erst in Databricks ankommt, nachdem Kameleoon das Zeitfenster, zu dem er gehört, bereits abgefragt hat. Um verpasste Datensätze zu vermeiden, legen Sie den Ingestion-Zeitrahmen unten passend zur typischen Ankunftsverzögerung Ihrer Pipeline fest.
Ingestion-Zeitrahmen
Standardmäßig erlaubt Kameleoon bis zu 1 Stunde zwischen dem Auftreten eines Konversionsereignisses für Ihr Ziel und seiner Verfügbarkeit in Ihrem Databricks-Warehouse, und das Abfragefenster berücksichtigt diese Verzögerung automatisch. Wenn Ihre Pipeline länger als 1 Stunde benötigt, um Ereignisse in Databricks zu schreiben, zum Beispiel aufgrund von Batch- oder nächtlichen ETL-Jobs, fallen diese verspätet eintreffenden Datensätze außerhalb des Abfragefensters und werden verpasst. Wenden Sie sich an Ihren Customer Success Manager, um die Verzögerung zu verlängern, damit sie der tatsächlichen Ankunftsverzögerung Ihrer Pipeline entspricht.Ihre Abfrage vor der Ingestion ausführen
Bevor Sie Ihre Ingestion-Aufgabe speichern, können Sie Ihre Abfrage direkt in Kameleoon testen. Tests ermöglichen es Ihnen:- Die Verbindung in Echtzeit zu überprüfen.
- Zu bestätigen, dass Ihre Anmeldedaten und Zugriffsrechte korrekt sind, was dabei hilft, Probleme sofort zu erkennen, ohne auf den ersten Datenimport warten zu müssen.
- Die Struktur und Zugänglichkeit Ihrer Daten zu validieren.