

データウェアハウス連携は、Web Experimentation および Feature Experimentation モジュールのプレミアムアドオンとしてご利用いただけます。詳細については、カスタマーサクセスマネージャーまでお問い合わせください。
オーディエンスターゲティングを設定する
Snowflakeのオーディエンスで訪問者をターゲティングするには、ソース機能を有効化し、Data Ingestion Taskを作成して、収集したデータからセグメントを作成します。作業を始める前に、プロジェクトで Snowflake 連携を有効化してください。- 機能を有効化する: 選択したプロジェクトの設定で、Use Snowflake as a source を展開します。機能が有効になると、そのステータスに Enabled と表示されます。
- Data Ingestion Taskを作成する: 機能を有効化したら、Add new task をクリックして Data Ingestion Taskを作成します。各タスクは、設定した頻度でクエリを実行します。
- Validate: タスクの情報を入力したら、Confirm をクリックしてタスクを作成します。追加のタスクを作成するには、手順 2を繰り返します。タスクの設定が終わったら、Validate をクリックして設定を保存し、適用します。
- カスタムデータを作成する: Kameleoonは、設定した頻度でクエリを実行し、データを収集します。収集したデータを使用するには、カスタムデータを作成します。
- セグメントを作成する: 収集したデータからセグメントを作成し、収集したデータに含まれる訪問者をターゲティングします。
Data Ingestion Tasks
Data Ingestion Taskは、設定した頻度で Snowflake データベースに対して SQL クエリを実行し、結果をオーディエンスとして Kameleoonに保持します。このオーディエンスには、インポートしたオーディエンスをターゲティングするで説明するように、カスタムデータとセグメントを通じてアクセスします。Data Ingestion Taskを作成する
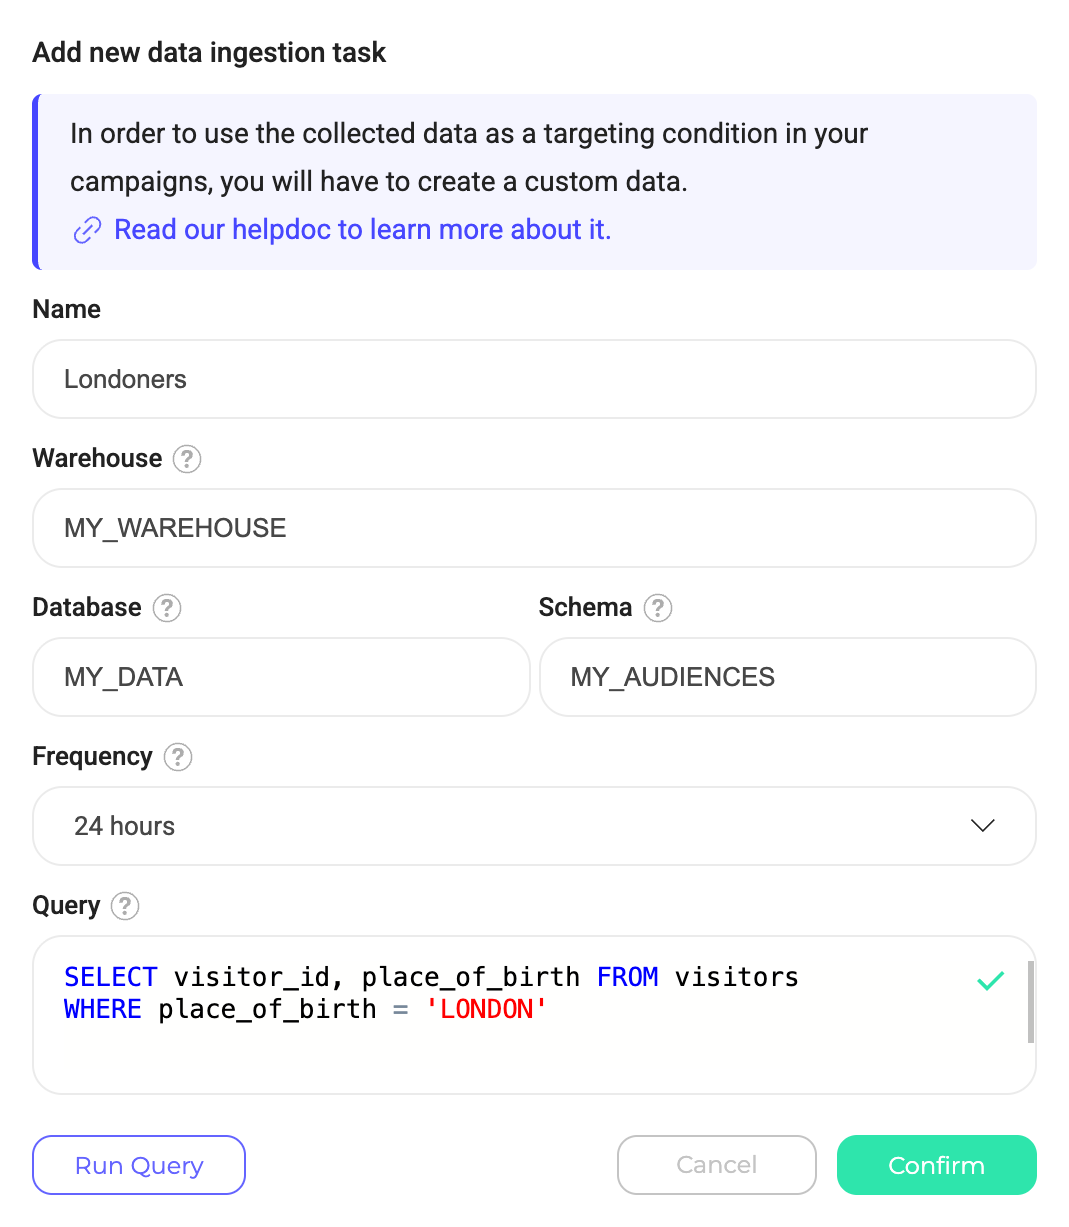
Kameleoonに Snowflakeからオーディエンスを取り込ませたい場合は、Data Ingestion Taskを作成します。- Add new task をクリックします。

- フォームに入力します:
- Name(必須): 目的が識別できるよう、タスクに一意でわかりやすい名前を付けます。
- Warehouse(必須): Snowflake ウェアハウスの名前を入力します。
- Database(必須): 取り込むデータを含む Snowflake データベースの名前を入力します。
- Frequency(必須): タスクを実行して Snowflakeからデータを取得する頻度を選択します(例:1日1回)。
- Query(必須): オーディエンスを取得する SQL クエリを入力します。クエリは次の形式に従う必要があります:
SELECT visitor_id, attribute_1, ..., attribute_N FROM your_events_table visitor_id(必須): 訪問者の一意の識別子を格納している列です。attribute_フィールド: これらは任意です。高度なターゲティングに使用します。これらのユースケースについては、インポートしたオーディエンスをターゲティングするで説明しています。

_)のみを使用できます。列名を数字で始めることはできません。
列は指定された順序どおりに並べる必要があります。visitor_idを先頭にし、その後に任意の属性を続けます。順序が異なると、連携は正しく動作しません。
- Confirm をクリックして Data Ingestion Taskを作成します。
インジェスチョン前にクエリを実行する
Data Ingestion Taskを保存する前に、Kameleoonでクエリを直接テストできます。テストにより、次のことが可能になります:- リアルタイムで接続を確認する。
- 認証情報とアクセス権が正しいことを確認し、最初のデータインポートを待たずに問題をすぐに検出する。
- データの構造とアクセス可能性を検証する。
オーディエンスのポーリングの仕組み
コンバージョンゴールのポーリングとは異なり、Data Ingestion Taskは、開始地点を記録して新しいレコードだけを取得するのではなく、スケジュールされたポーリングのたびに SQL クエリ全体を再実行します。Kameleoonは、各ポーリングの結果を前回の結果と比較し、差分、つまりオーディエンスに追加または削除された訪問者だけを Kameleoon プロジェクトに送信します。各ポーリングは完全で最新のオーディエンスを返すため、Snowflakeのクエリでタイムスタンプによるフィルタリングを行う必要はありません。 タスクを作成すると、Kameleoonは Snowflakeのポーリングを開始し、ポーリングされたデータはすぐにターゲティングに使用できるようになります。Web 実験では Activation API を、Feature Experimentationでは Kameleoon SDK を使用して、このデータを読み取ります。ポーリングの失敗とクエリの変更
ポーリングが失敗するとオーディエンスは変更されませんが、エラーなく実行されるクエリであれば、オーディエンスが変わる場合があります。 ポーリングが失敗すると、Kameleoonは失敗を記録します。その後、次に成功するポーリングまで、オーディエンスは最後に成功したポーリングの訪問者を保持します。 クエリ自体が失敗した場合(たとえば SQLが無効な場合)、ポーリングは同じように失敗し、オーディエンスは以前の訪問者を保持します。 クエリは実行されるものの異なる行を返す場合、Kameleoonは新しい結果に合わせて訪問者を追加・削除します。その際、エラーは表示されません。 クエリが読み取るテーブルまたはビューの名前を変更したり、構造を変更したりした場合は、インジェスチョン前にクエリを実行するで説明するように、クエリを再実行して、期待どおりの列が返されることを確認してください。インジェスチョン時間枠
コンバージョンゴールのポーリングなど、一部の Snowflake ポーリングは移動する時間枠を追跡します。これらのポーリングでは、イベントが時間枠に通過される前に、ウェアハウスで利用可能になるまでの遅延を設定できます。Data Ingestion Taskは時間枠を追跡する代わりに、ポーリングのたびにオーディエンスのクエリ全体を再実行するため、その時点で Snowflakeに存在するデータをそのまま取得し、この遅延の影響は受けません。インジェスチョンのタイミングがオーディエンスデータにどう影響するかについて質問がある場合は、カスタマーサクセスマネージャーにお問い合わせください。Data Ingestion Taskを更新する
名前、頻度、ウェアハウス、データベース、クエリを変更する必要がある場合は、Data Ingestion Taskを更新します。- タスクを選択する: ドロップダウンメニューから Data Ingestion Taskを選択します。
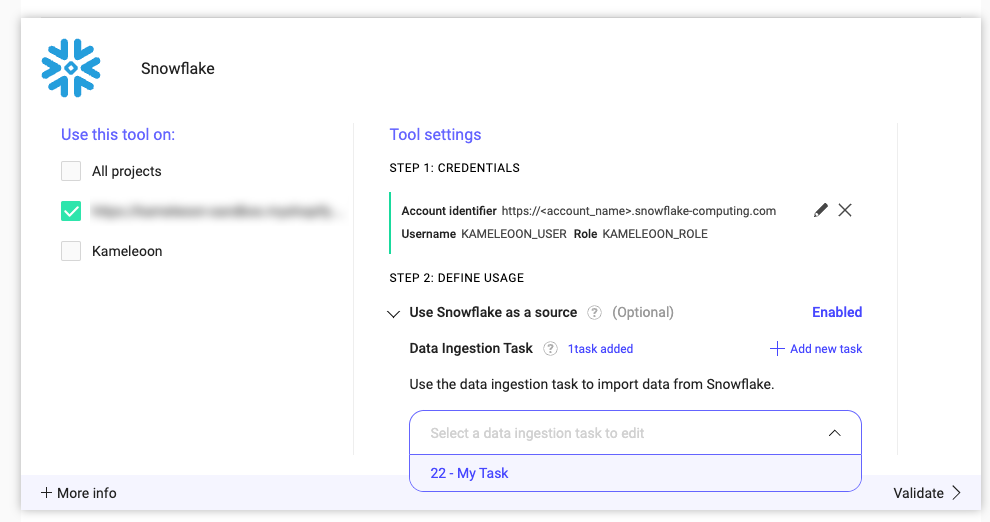
- タスクの詳細を編集する: 更新するフィールドを変更します。
- 変更を確定する: Confirm をクリックして、Data Ingestion Taskへの変更を保存します。
Data Ingestion Taskを削除する
不要になった Data Ingestion Taskは削除します。タスクを削除する前に、関連するカスタムデータを削除してください。
- タスクを選択する: ドロップダウンメニューから Data Ingestion Taskを選択します。
- 削除を開始する: Delete ingestion task をクリックします。
- 削除を確定する: Confirm をクリックして、選択した Data Ingestion Taskを削除します。
インポートしたオーディエンスをターゲティングする
各 Data Ingestion Taskはオーディエンスを定義します。このオーディエンスは、カスタムデータとセグメントを使ってターゲティングします。次の 2 つの方法から選択してください:- 事前構築されたオーディエンス: タスクのオーディエンス全体をターゲティングします(例:「The Londoners」のすべての訪問者)。タスクのオーディエンスをすべて一覧にしたカスタムデータを 1 つ作成してから、そこからセグメントを作成します。
- 訪問者の属性: 多くの値を持つ属性(例:各訪問者の出生都市)をターゲティングします。その属性を
visitor_idの後のフィールドとして SQL クエリに追加し、その値を保持するカスタムデータを作成します。