

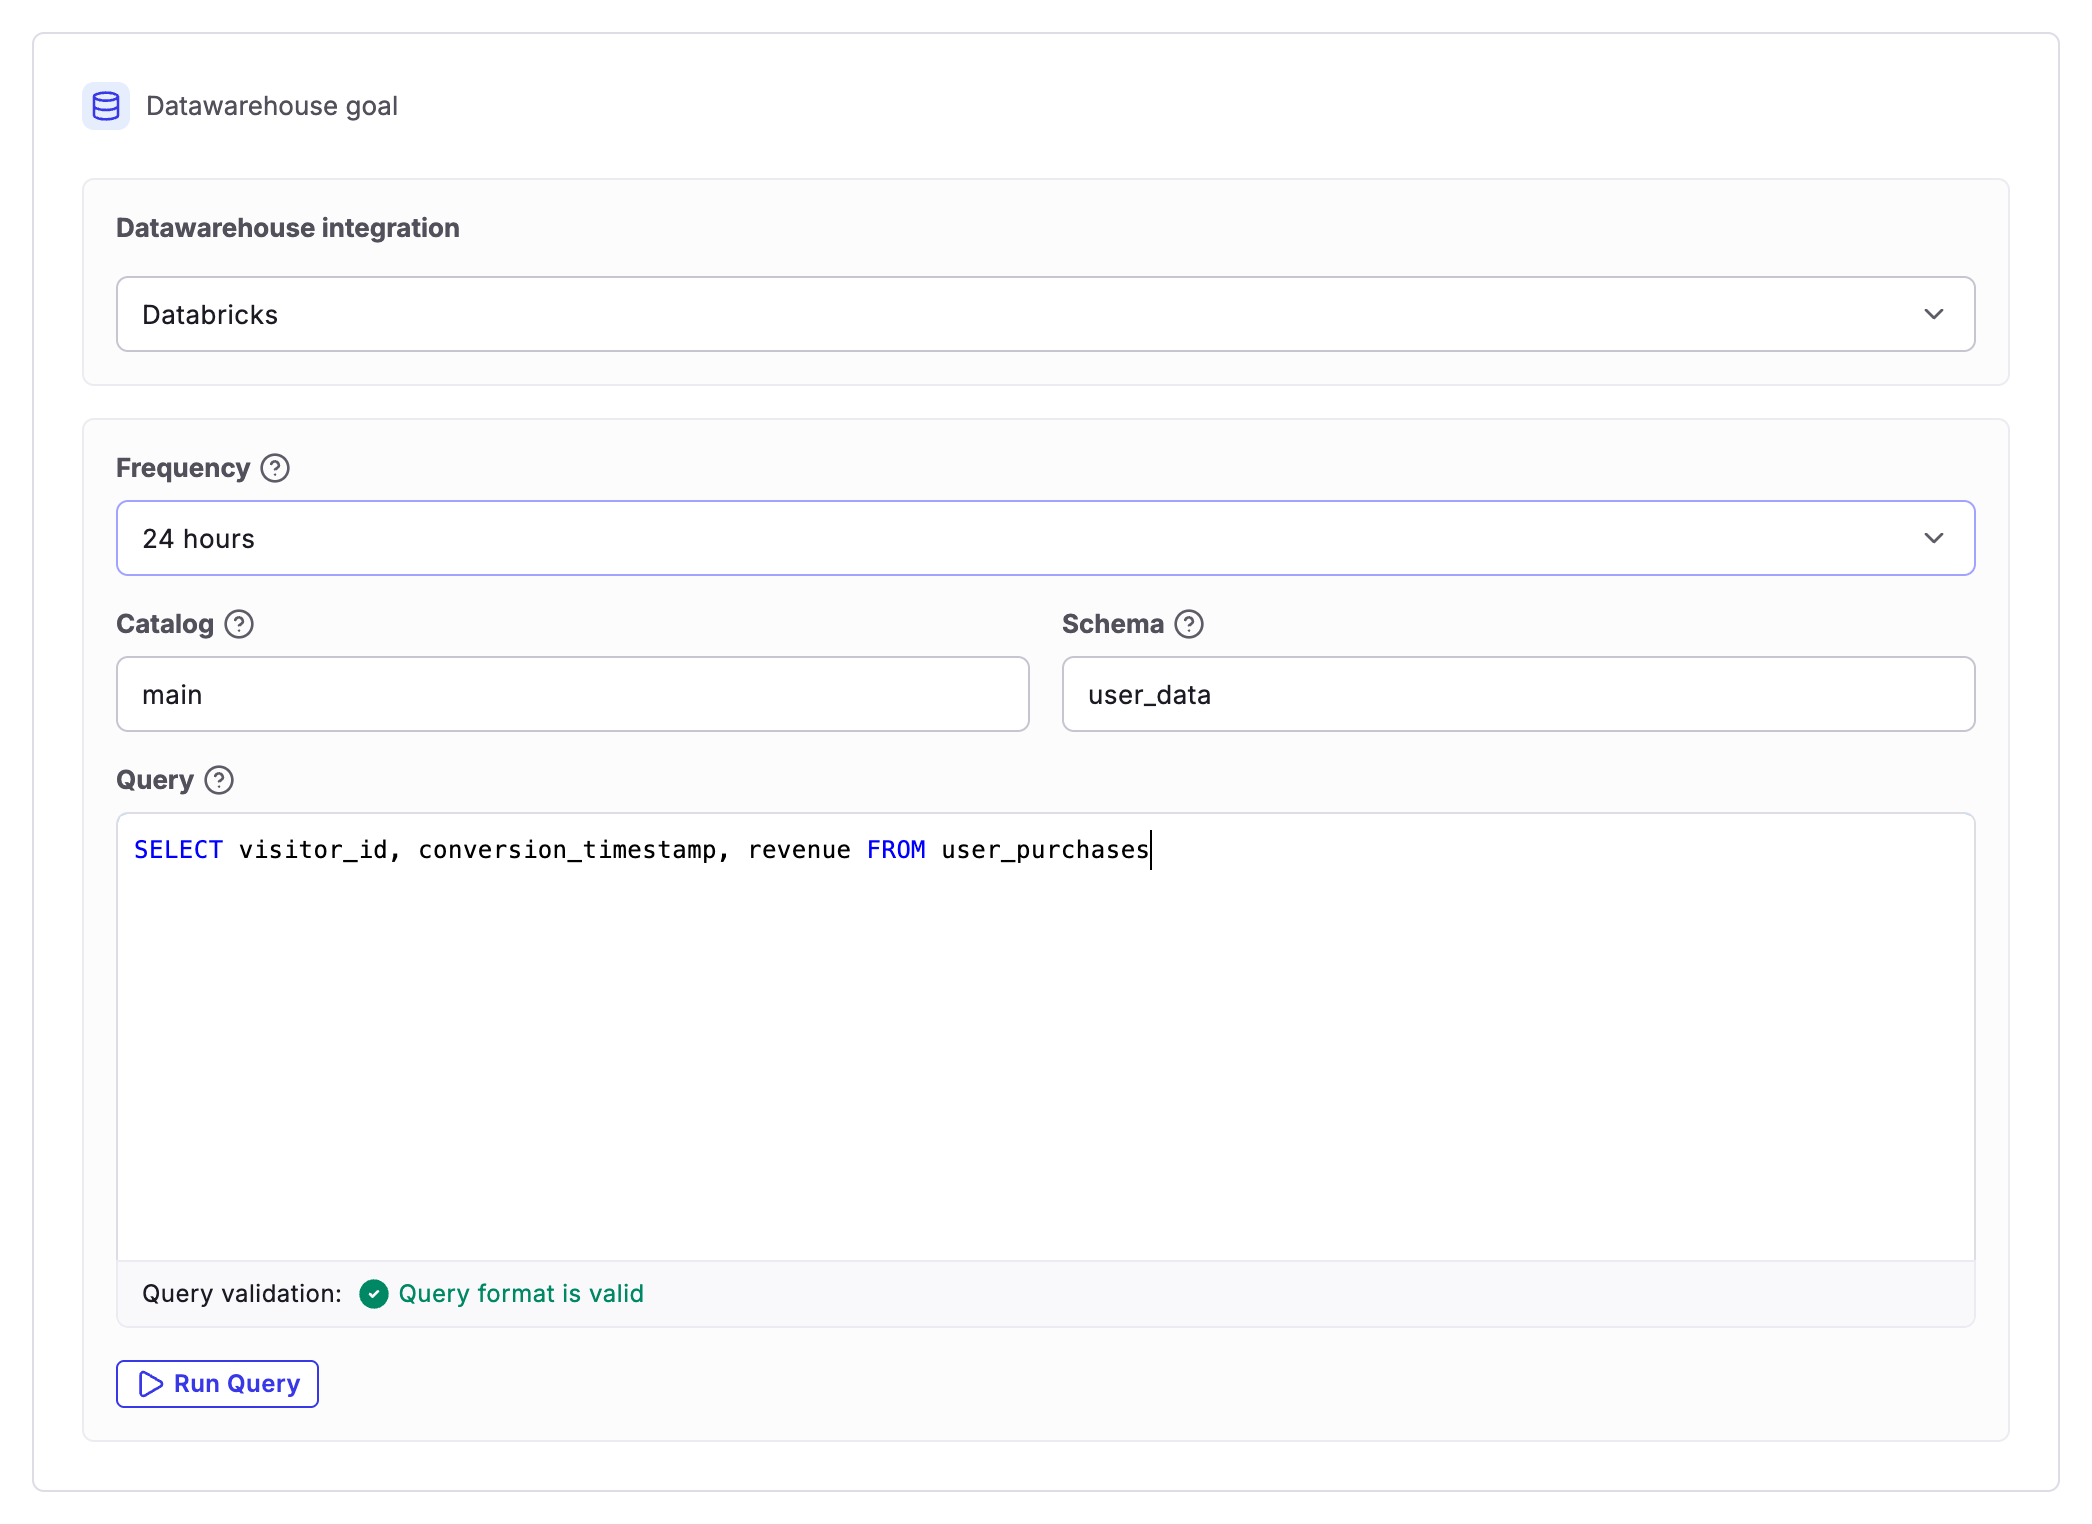
- Frequency : sélectionnez la fréquence d’exécution de la tâche.
- Catalog : saisissez le nom du catalogue Databricks qui contient les schémas que vous souhaitez que Kameleoon lise.
- Schema : saisissez le schéma qui contient vos données de conversion.
- Query : définissez la requête SQL qui récupère les données nécessaires depuis Databricks.
Format de la requête
La requête doit respecter un format spécifique :visitor_id est la colonne qui représente l’identifiant unique de vos visiteurs, et conversion_timestamp est une colonne qui représente l’heure exacte à laquelle la conversion a eu lieu. Dans Databricks, la colonne conversion_timestamp doit être de type Timestamp.
Si vous souhaitez associer un revenu à chaque conversion, la requête doit respecter un format alternatif :
revenue est une colonne qui contient le revenu de chaque conversion.
Pour les requêtes plus complexes, vous pouvez respecter ce format en formulant une sous-requête comme suit :
Comment Kameleoon interroge les données de conversion
Kameleoon interroge les données de conversion Databricks de votre objectif toutes les heures, en ajoutant à votre requête une clauseWITH qui filtre par horodatage. Plutôt que de recharger tout l’historique des événements à chaque exécution, Kameleoon interroge les données de manière incrémentale : chaque tâche d’interrogation conserve le dernier point d’interrogation réussi et, lors de l’exécution suivante, n’interroge que la fenêtre temporelle des nouveaux enregistrements arrivés depuis ce point. N’interroger que cette fenêtre garde chaque interrogation rapide, puisque Kameleoon ne relit jamais les données déjà importées. Kameleoon fusionne les conversions collectées avec les résultats de votre expérience une fois par jour, vers midi (CET). Jusqu’à la prochaine fusion, les chiffres des dernières 24 heures d’un objectif Databricks peuvent afficher zéro.
Comme l’interrogation avance toujours dans le temps, Kameleoon peut manquer un enregistrement qui arrive dans Databricks avec un horodatage antérieur à la dernière fenêtre d’interrogation réussie. Les enregistrements tardifs arrivent généralement parce que votre pipeline de données met du temps à écrire l’événement de conversion : l’enregistrement n’atteint Databricks qu’après que Kameleoon a déjà dépassé la fenêtre temporelle à laquelle il appartient. Pour éviter les enregistrements manqués, définissez le délai d’ingestion ci-dessous pour qu’il corresponde au délai d’arrivée habituel de votre pipeline.
Délai d’ingestion
Par défaut, Kameleoon accepte jusqu’à 1 heure entre le moment où un événement de conversion de votre objectif se produit et celui où il devient disponible dans votre entrepôt Databricks. La fenêtre d’interrogation tient compte automatiquement de ce délai. Si votre pipeline met plus d’une heure pour écrire les événements dans Databricks, par exemple à cause de traitements ETL par lots ou nocturnes, ces enregistrements tardifs tombent en dehors de la fenêtre d’interrogation et sont manqués. Contactez votre Customer Success Manager pour prolonger le délai afin qu’il corresponde au délai d’arrivée réel de votre pipeline.Exécuter votre requête avant l’ingestion
Avant d’enregistrer votre tâche d’ingestion, vous pouvez tester votre requête directement dans Kameleoon. Le test vous permet de :- Vérifier la connexion en temps réel.
- Confirmer que vos identifiants et vos droits d’accès sont corrects, ce qui permet de détecter immédiatement les problèmes sans attendre le premier import de données.
- Valider la structure et l’accessibilité de vos données.
Utiliser votre objectif Databricks
Maintenant que vous avez créé un objectif, vous pouvez l’intégrer à vos campagnes Kameleoon. Lorsque vous configurez une expérience ou une personnalisation, vous pouvez sélectionner l’objectif, ce qui vous permet de suivre et d’analyser des conversions spécifiques dans votre base de données Databricks. Kameleoon fusionne ces conversions avec les résultats de vos expériences une fois par jour, vers midi (CET). Pour savoir comment configurer un objectif dans une expérience, consultez Configurer un objectif pour une campagne.Conservation des données
Les données de conversion importées depuis Databricks deviennent des données de visite dans Kameleoon et suivent la politique de conservation standard de Kameleoon. Pour la durée de conservation, consultez la Politique de rétention des données.Supprimer les données d’un visiteur
Vous pouvez supprimer la copie de Kameleoon des données d’un visiteur avec l’endpointPOST /visit/forget de la Data API, qui nécessite une authentification. Pour le format de la requête, consultez Remove data for several visitors. Cet endpoint ne supprime pas les tables de votre workspace Databricks.