

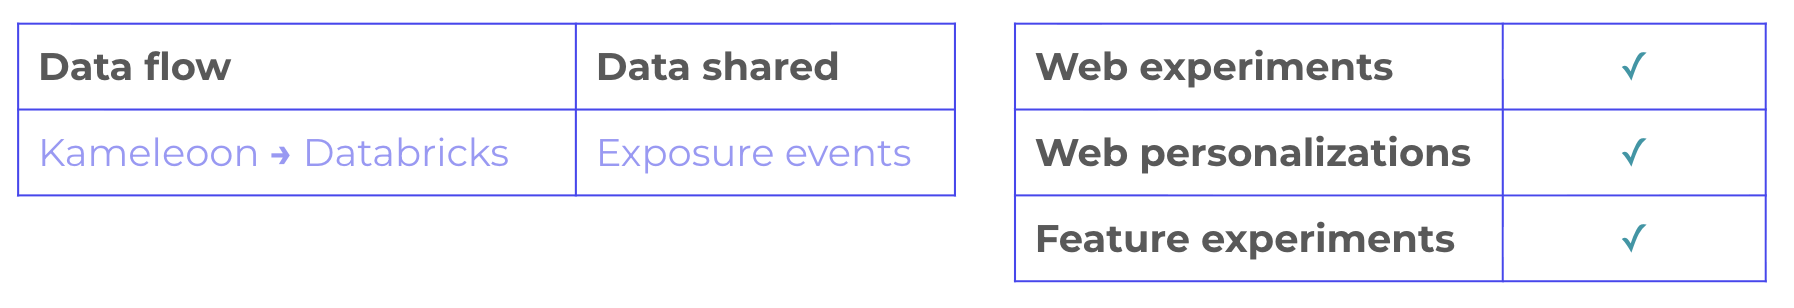
Activer Databricks comme destination
Pour activer Databricks comme destination :- Cliquez sur Use Databricks as a destination.
- Databricks catalog : nom du « catalog » Databricks qui contient le schéma Kameleoon dans lequel écrire (le dossier de premier niveau).
- Schema : schéma dans lequel Kameleoon écrit sa table d’événements, par exemple
kameleoon_events.

Ce que fait « Use Databricks as a destination »
Après avoir activé Use Databricks as a destination, Kameleoon écrit chaque événement d’exposition aux expériences dans Databricks. Kameleoon stocke les événements dans le schémakameleoon_events de votre catalogue Databricks. Ce catalogue est celui que vous avez configuré en suivant Configurer Databricks, avec un accès en écriture accordé au service principal de Kameleoon. Kameleoon enregistre les données dans une table nommée kameleoon_experiment_event et écrit chaque exposition sous la forme d’une ligne. Vos propres paramètres Databricks déterminent la durée de conservation de ces lignes.
Une exposition atteint votre table Databricks en deux étapes : un SDK web, mobile ou serveur envoie la charge utile d’exposition à l’Ingestion API de Kameleoon, puis Kameleoon l’écrit dans Databricks au moyen d’une insertion authentifiée.
Kameleoon ne conserve pas de copie des événements d’exposition. Il transmet chaque événement à Databricks, de sorte qu’une écriture échouée perd cet événement. Kameleoon ne relance pas les écritures échouées, et il n’envoie aucune notification en cas d’échec d’écriture.
Le schéma SQL de cette table est le suivant :
custom_visitor_id depuis la custom data Cross-device experimentation, si vous l’avez définie.