Las integraciones con data warehouses están disponibles como complemento premium para el módulo Web Experimentation y Feature Experimentation de Kameleoon. Para obtener más información, póngase en contacto con su Customer Success Manager.
- Permite segmentar visitantes con audiencias creadas a partir de sus tablas de Databricks.
- Permite usar las conversiones de Databricks como métricas de objetivo en los resultados de los experimentos.
- Databricks as a source: cada Data Ingestion Task se ejecuta con la Frequency que establece al crearla, por ejemplo, una vez al día. Kameleoon consulta cada hora los objetivos basados en consultas y combina las conversiones recopiladas con los resultados de los experimentos una vez al día. Consulte Data Ingestion Tasks.
- Databricks as a destination: Kameleoon envía eventos de exposición a Databricks cada vez que uno de sus experimentos expone a un visitante. Consulte Utilizar Databricks como destino.
Requisitos previos
Para configurar esta integración, necesita la siguiente información:- Personal access token (PAT) de Databricks
- Acceso adecuado para crear esquemas de Databricks y conceder acceso a ellos.
Configuración
1. Crear un personal access token (PAT)
Kameleoon se autenticará en su SQL warehouse de Databricks con un personal access token. Debe crear un service principal de Databricks y, a continuación, crear un PAT para esa cuenta de servicio. Una vez que haya creado un service principal, puede generar un PAT con la CLI de Databricks, utilizando el “Application Id” del service principal que encontrará en la página de gestión de service principals de la interfaz de usuario de Databricks.2. Crear esquemas de Kameleoon y conceder acceso a Unity Catalog
Para el origen y el destino, conceda al service principal el permiso CAN USE sobre el SQL warehouse de Databricks en su configuración de Permissions. Para Unity Catalog, conceda acceso a cada catálogo que utilice Kameleoon:CREATE SCHEMA en el catálogo.
Cuando se utiliza Databricks como fuente
Para la ingesta de audiencias, cree un esquema dedicado en el catálogo que contiene los datos que Kameleoon consulta. Asígnele el nombrekameleoon_configuration. Kameleoon crea, lee y elimina en este esquema las tablas de instantáneas de audiencias. Conceda al service principal acceso solo a este esquema. No necesita permisos de escritura sobre sus tablas de origen.
MODIFY también requiere SELECT sobre las tablas.
SELECT y MODIFY sobre esas tablas. Los siguientes permisos a nivel de esquema también cubren las tablas de eventos actuales y futuras de este esquema dedicado:
{Service Principal Application Id} en estos comandos por el application ID de su service principal.
Puede omitir el prefijo
my_catalog cuando ejecute consultas directamente en el catálogo necesario.3. Conceder acceso de lectura a sus datos
Para Databricks como fuente, conceda acceso solo a las tablas o vistas que utilicen sus consultas de audiencias y de objetivos. Primero, conceda acceso al esquema:SELECT sobre cada tabla o vista necesaria. Como alternativa, puede concederlo sobre el esquema si Kameleoon debe leer todas las tablas y vistas actuales y futuras de ese esquema:
SELECT ni MODIFY sobre el esquema de datos de sus clientes. Si utiliza objetivos sin ingesta de audiencias, Kameleoon solo lee los resultados de sus consultas y no crea instantáneas de audiencias.
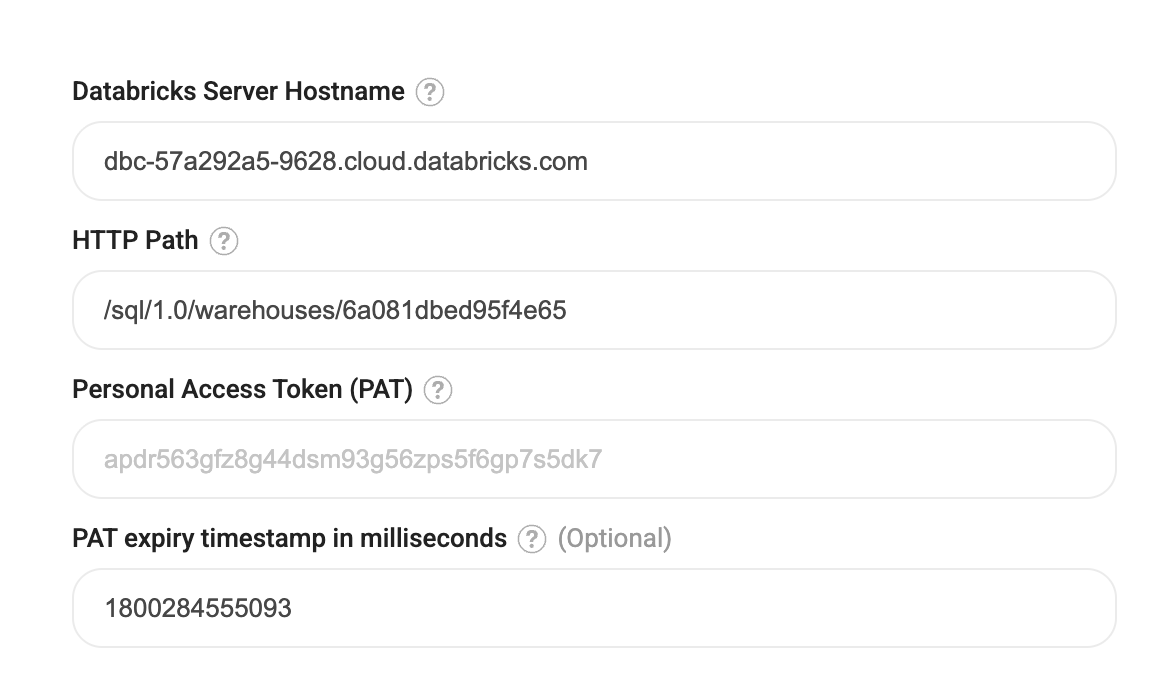
4. Introducir sus credenciales en Kameleoon
En la configuración de la integración de Databricks de su proyecto en Kameleoon, complete los campos de Credentials:- Databricks Server Hostname: el nombre de host del servidor de su workspace de Databricks.
- HTTP Path: la ruta a su SQL warehouse de Databricks.
- Personal Access Token (PAT): el token que creó en el paso 1.
- PAT expiry timestamp in milliseconds (optional): la hora de caducidad del token, expresada como marca de tiempo Unix en milisegundos. Este campo es opcional, y el valor lo introduce usted.