

データウェアハウス統合は、Web Experimentation および Feature Experimentation モジュールのプレミアムアドオンとして提供されています。詳細については、カスタマーサクセスマネージャーにお問い合わせください。
オーディエンスターゲティングを設定する
Amazon Redshift のオーディエンスで訪問者をターゲティングするには、次の手順を順番に実行します。- 機能を開く: 選択したプロジェクトの設定で Use Amazon Redshift as a source を開きます。機能が有効になると、ステータスに Enabled と表示されます。
- Data Ingestion Tasks を作成する: 機能が有効になったら、Add new task をクリックして Data Ingestion Task を作成します。フィールドについては Data Ingestion Tasks を参照してください。
- 確定して検証する: Confirm をクリックして各タスクを保存します。手順 2 を繰り返すと、タスクを追加で作成できます。完了したら Validate をクリックして、設定を保存して適用します。
- カスタムデータを作成する: Kameleoon は、設定した頻度で各クエリを Amazon Redshift インスタンスに対して実行し、データを収集し始めます。収集したデータを使用するには、カスタムデータを作成します。
- セグメントを作成する: カスタムデータに基づいてセグメントを作成し、収集したデータを持つ訪問者をターゲティングします。
Data Ingestion Tasks
Data Ingestion Task は、設定した頻度で Redshift データベースに対して SQL クエリを実行し、その結果をオーディエンスとして取り込みます。各タスクには、クエリ、クラスターの詳細、実行頻度が必要です。 Kameleoon は、各タスクに設定した頻度でウェアハウスをポーリングします。ポーリングに成功すると、そのオーディエンスをキャンペーンのターゲティングに使用できます。ポーリングしたデータは、ウェブ実験には Activation API を、Feature Experimentation には Kameleoon の SDK を使用して利用できます。 ポーリングに失敗すると、Kameleoon は失敗を記録します。その後、正常にポーリングが完了するまで、オーディエンスは最後に正常にポーリングされた時点のメンバーシップを保持します。Data Ingestion Task を作成する
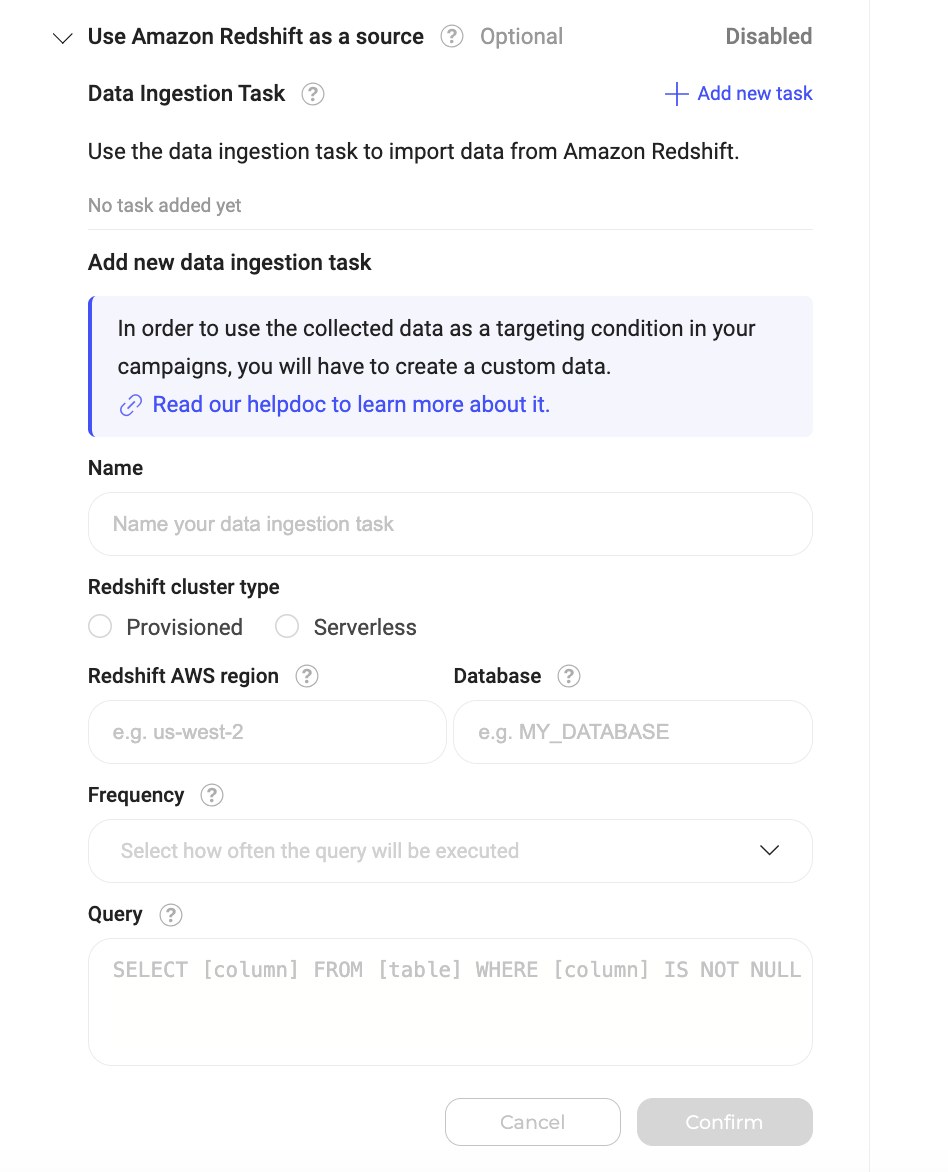
Data Ingestion Task を作成するには:- Add new task をクリックします。
- フォームに入力します:
- Name (Required): タスクの目的を識別できる、一意で分かりやすい名前を付けます。
- Redshift cluster type (Required): プロビジョニング済みまたはサーバーレスの Redshift クラスターのどちらを使用するかを指定します。Provisioned を選択した場合は、クラスター ID を指定する必要があります。Serverless を選択した場合は、namespace と workgroup を指定する必要があります。
- Redshift AWS region (Required): Redshift クラスターのリージョンコードです。AWS コンソールで確認できます。例:
us-west-2 - Database (Required): 取り込むデータを含む Redshift データベースの名前です。
- Frequency (Required): タスクを実行し、Amazon Redshift からデータを取得する頻度を指定します(例:1 日ごと)。
- Query (Required): Amazon Redshift データベースからオーディエンスを取得する SQL クエリを指定します。クエリは次の形式に従う必要があります:
SELECT visitor_id, attribute_1, ..., attribute_N FROM your_events_table attribute_フィールド: これらは任意で、高度なターゲティングシナリオで使用できます。これらの高度なユースケースの詳細は、インポートしたオーディエンスをターゲティングするを参照してください。visitor_id: Kameleoon が各訪問者のオーディエンスデータを検索するために使用する識別子です。コードでオーディエンスを取得するときに渡す値と同じ値を使用します。これは Kameleoon の訪問者コードか、独自のwarehouseKeyのいずれかです。識別子の選び方については、訪問者識別を参照してください。
- Confirm をクリックして Data Ingestion Task を作成します。
ガイドライン
列の命名
列名には、文字、数字、アンダースコア(_)のみを使用できます。数字で始めることはできません。
列の順序
統合が正しく機能するように、列は指定された順序(visitor_id、その後に任意の属性)で並べる必要があります。
インジェスチョン前にクエリを実行する
取り込みタスクを保存する前に、Kameleoon でクエリを直接テストできます。テストでは次のことができます:- リアルタイムで接続を確認する。
- 認証情報とアクセス権が正しいことを確認する。これにより、最初のデータインポートを待たずに問題をすぐに検出できます。
- データの構造とアクセス性を検証する。
Data Ingestion Task を更新する
Data Ingestion Task を更新するには:- タスクを選択する: ドロップダウンメニューから Data Ingestion Task を選択します。
- タスクの詳細を編集する: タスク名、頻度、Redshift クラスター、リージョン、データベース、クエリなど、更新するフィールドを変更します。
- 変更を確定する: Confirm をクリックして、Data Ingestion Task への変更を保存します。
Data Ingestion Task を削除する
Data Ingestion Task を削除する前に、関連付けられているカスタムデータを削除します。Data Ingestion Task を削除するには: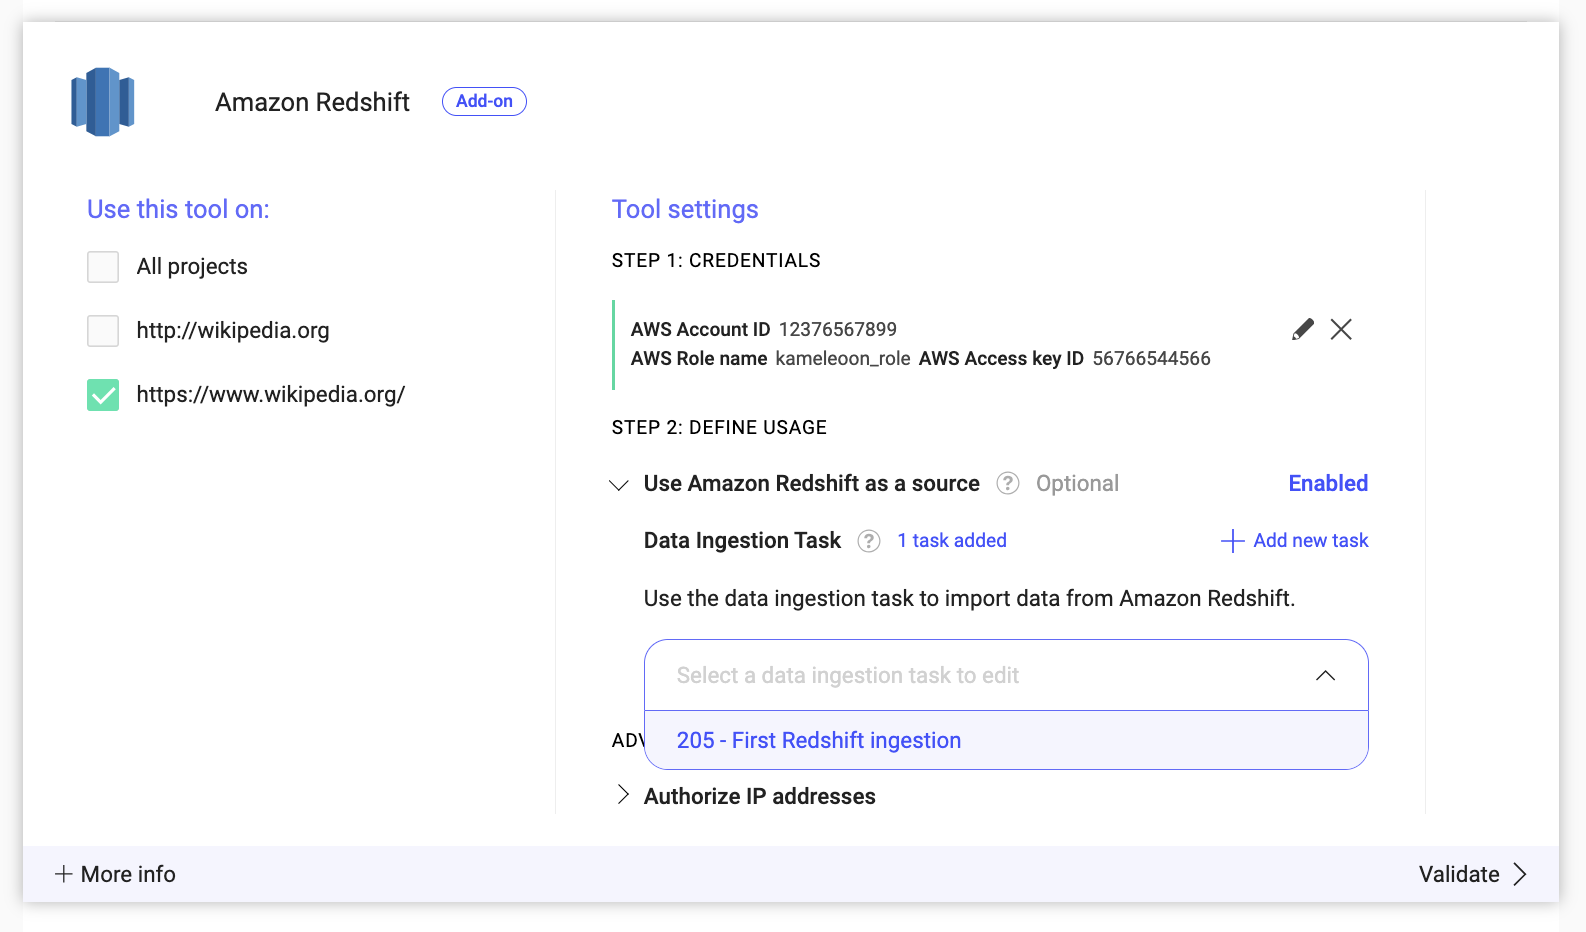
- タスクを選択する: ドロップダウンメニューから Data Ingestion Task を選択します。
- 削除を開始する: Delete data ingestion task をクリックします。
- 削除を確定する: Confirm をクリックして、選択した Data Ingestion Task を削除します。
インポートしたオーディエンスをターゲティングする
各 Data Ingestion Task はオーディエンスを定義し、そのオーディエンスは、カスタムデータエントリとセグメントを通じてターゲティングします。ターゲティングの目的に合ったアプローチを選択してください:- 事前に構築されたオーディエンス: 例:ロンドン生まれのすべての訪問者。Ingestion Task のすべてのオーディエンスを一覧にしたカスタムデータエントリを 1 つ作成し、そこからセグメントを作成します。
- 訪問者の属性: 例:訪問者ごとの出生都市(多くの異なる値があります)。属性をクエリ内の
visitor_idの後のフィールドとして追加し、その値を保持するカスタムデータエントリを作成します。